NEFER : Neuromorphic Event-based Facial Expression Recognition

0. Abstract
NEFER dataset 제작 및 baseline 모델 연구
1. Introduction
- Emotion은 micro-expression을 수반함. (최대 1/25초) [12]
- Facial expression 연구 중 RGB 대비 event 데이터의 성능이 향상된 연구 결과 존재 [2]
- 선행 연구 : Understanding Human Reactions Looking at Facial Microexpressions With an Event Camera [2]
- positive / negative로 표현
- cons : VGA event camera 사용
- 제안하는 method : ESIM 사용 → hybrid approach
- Contribution
- Propose event dataset for emotion recognition
- RGB 데이터에 대한 face / landmark label 제안
2. Related Works
- Event camera 소개 (novel bio-inspired paradigm, async, short time interval, low latency, conserve resource etc.)
- [A 128x128 120 dB 15 s Latency Asynchronous Temporal Contrast Vision Sensor]: Event camera latency 관련
- NeuroIV: Neuromorphic Vision Meets Intelligent Vehicle Towards Safe Driving With a New Database and Baseline Evaluations [6] : 차량 내 remote face
- 기존 존재했던 datasets : [2, 33, 51] → low resolution camera를 사용했다는 문제
3. NEFER: Neuromorphic Event-based Facial Expression Recognition
- 목표 : Event camera와 RGB 카메라로 특정 감정과 관련한 미세 표정을 포착하는 것
3.1 Setting and protocol
- 참가 인원 및 성별, 주의 사항, 참가자에게 제공한 영상 길이(7s)
- 절차 참고 논문[10 : SAMM, 66 : CASEME]
- 장비 소개(고프로, Prophesee), 환경 구성
4. Video Annotation Through Simulated Events
- Challenge
- RGB 기반 기능들은 Event camera에 사용 불가
- Frame-based 도구와 함께 사용하기 위해서는 neuromorphic sensor의 raw data 전처리 필수
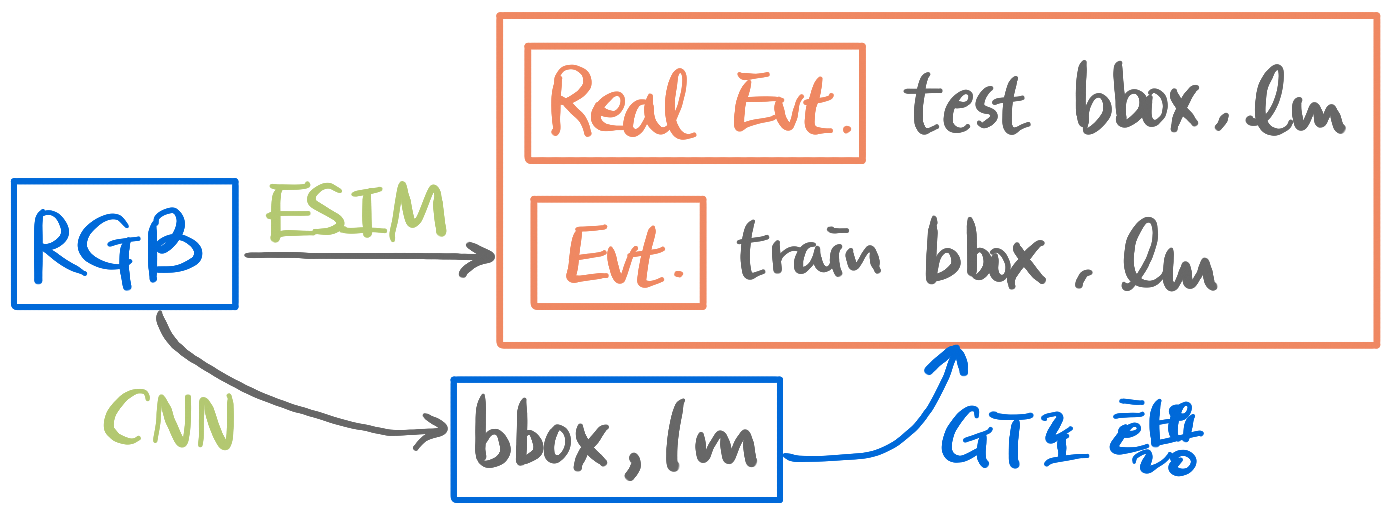
ESIM 활용
4.1 ESIM
- ESIM : Event 기반 카메라 simulator, 이전에 예측한 신호를 기반으로 frame 속도 조절, 카메라 궤적에 따라 frame 보간 → high frame rate image rendering
- 모든 RGB 이미지를 simulator에 입력 → 각 stream마다 합성 데이터를 생성함
- The simulator-generated outputs are encoded using an exponential time surface[31] (?)
- 합성 데이터는 오로지 annotation을 위해 생성됨. Final dataset에는 사용되지 않음.
4.2 Face Detection
- FaceAlignment open-source를 활용해 RGB dataset에서 GT 추출
- Face label을 합성 데이터에 bounding → 합성 데이터를 YOLOv2에 학습시킴
- CVAT를 이용해 수작업 수정
4.3 Landmark Detection
- FaceAlignment open-source를 활용해 RGB dataset에서 GT 추출 (68개의 landmarks)
- Face label을 합성 데이터에 bounding → 합성 데이터를 Xception에 학습시킴
5. Baseline Method
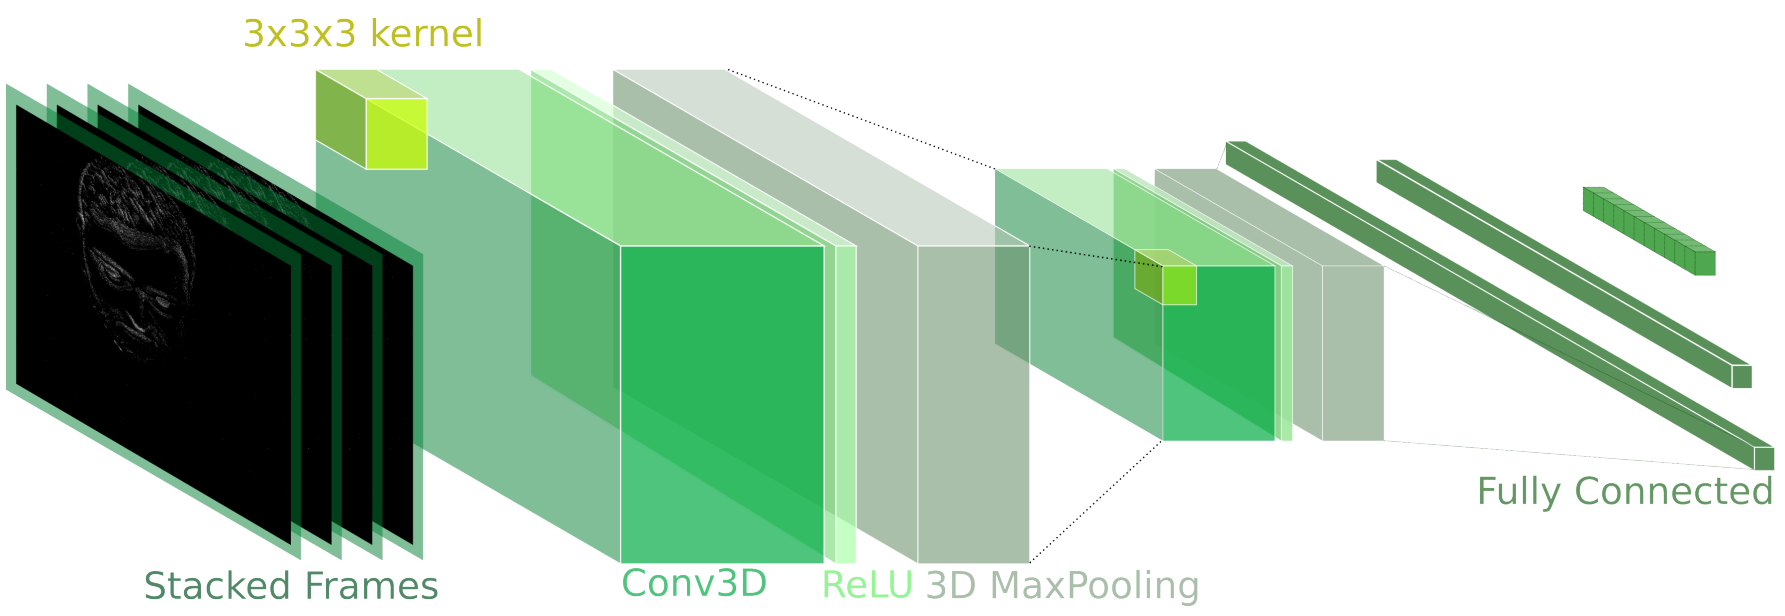
- C3D 활용한 baseline 제공 [Learning spatiotemporal features with 3d convolutional networks] (ICCV, 2015)
- Video 기반 action, activity recognition task에 오랫동안 사용되어 온 방식
5.1 Temporal Binary Representation
Events를 모아 synchronous한 frame으로 변환 → 표준 CV pipeline에서 동작하게 함
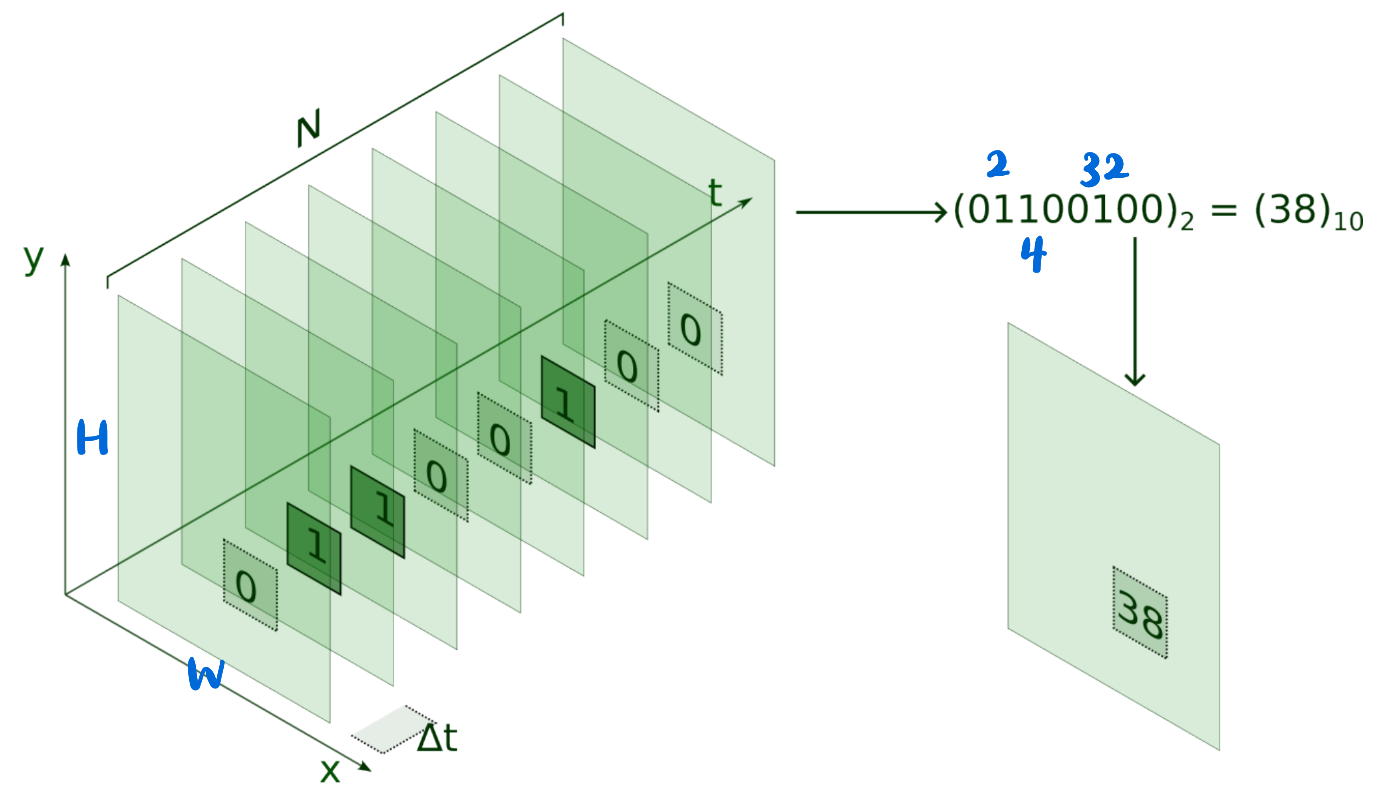
- 고정된 시간 $\Delta t$ 마다 추출한 event로 N개의 consecutive representation을 추출
- 좌표마다 binary value를 가짐 : $b^i_{x,y}=\mathbb{1}(x,y)$
- binary value aggregate
- parameter setting : $\Delta t = 15, N=8$ → 계산하면 120ms마다 output 생성
6. Experimental Results
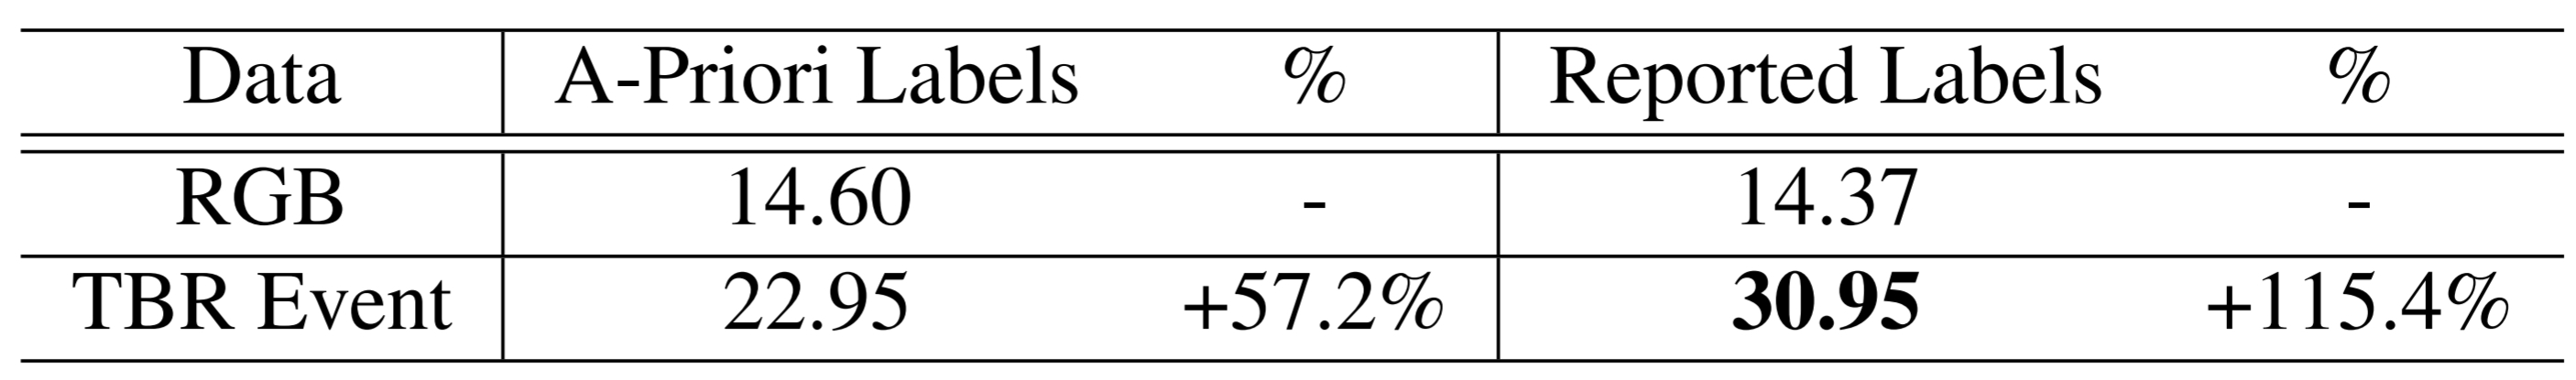
- Event camera가 face 분석에 적합함
- Event footage(async한 데이터 값)이 micro-expressions task를 수행하는 데 유의미한 정보를 제공함
- Self-reported 실험에서 비슷한 감정(fear & surprise, anger & contempt)을 혼동하는 경향을 보임
- Control experiment 수행
- RGB 데이터를 pre-trained된 frame-based framework에 넣음
- 감정에 대한 단서는 매우 빠르게 전달되는데, 대부분의 frame에서는 expression이 강한 감정을 전달하지 못함(예측값이 neutral이 많음)
7. Conclusions and Future Work
- Future larger collection of data in the event camera의 초석
- RGB와 event 분야에서 최상의 요소를 결합하고 event domain에서 더 효과적으로 다룰 수 있는 문제를 다루고자 함