FIFA: Fine-grained Inter-frame Attention for Driver's Video Gaze Estimation
CVPR, 2025
[Paper]
Introduction
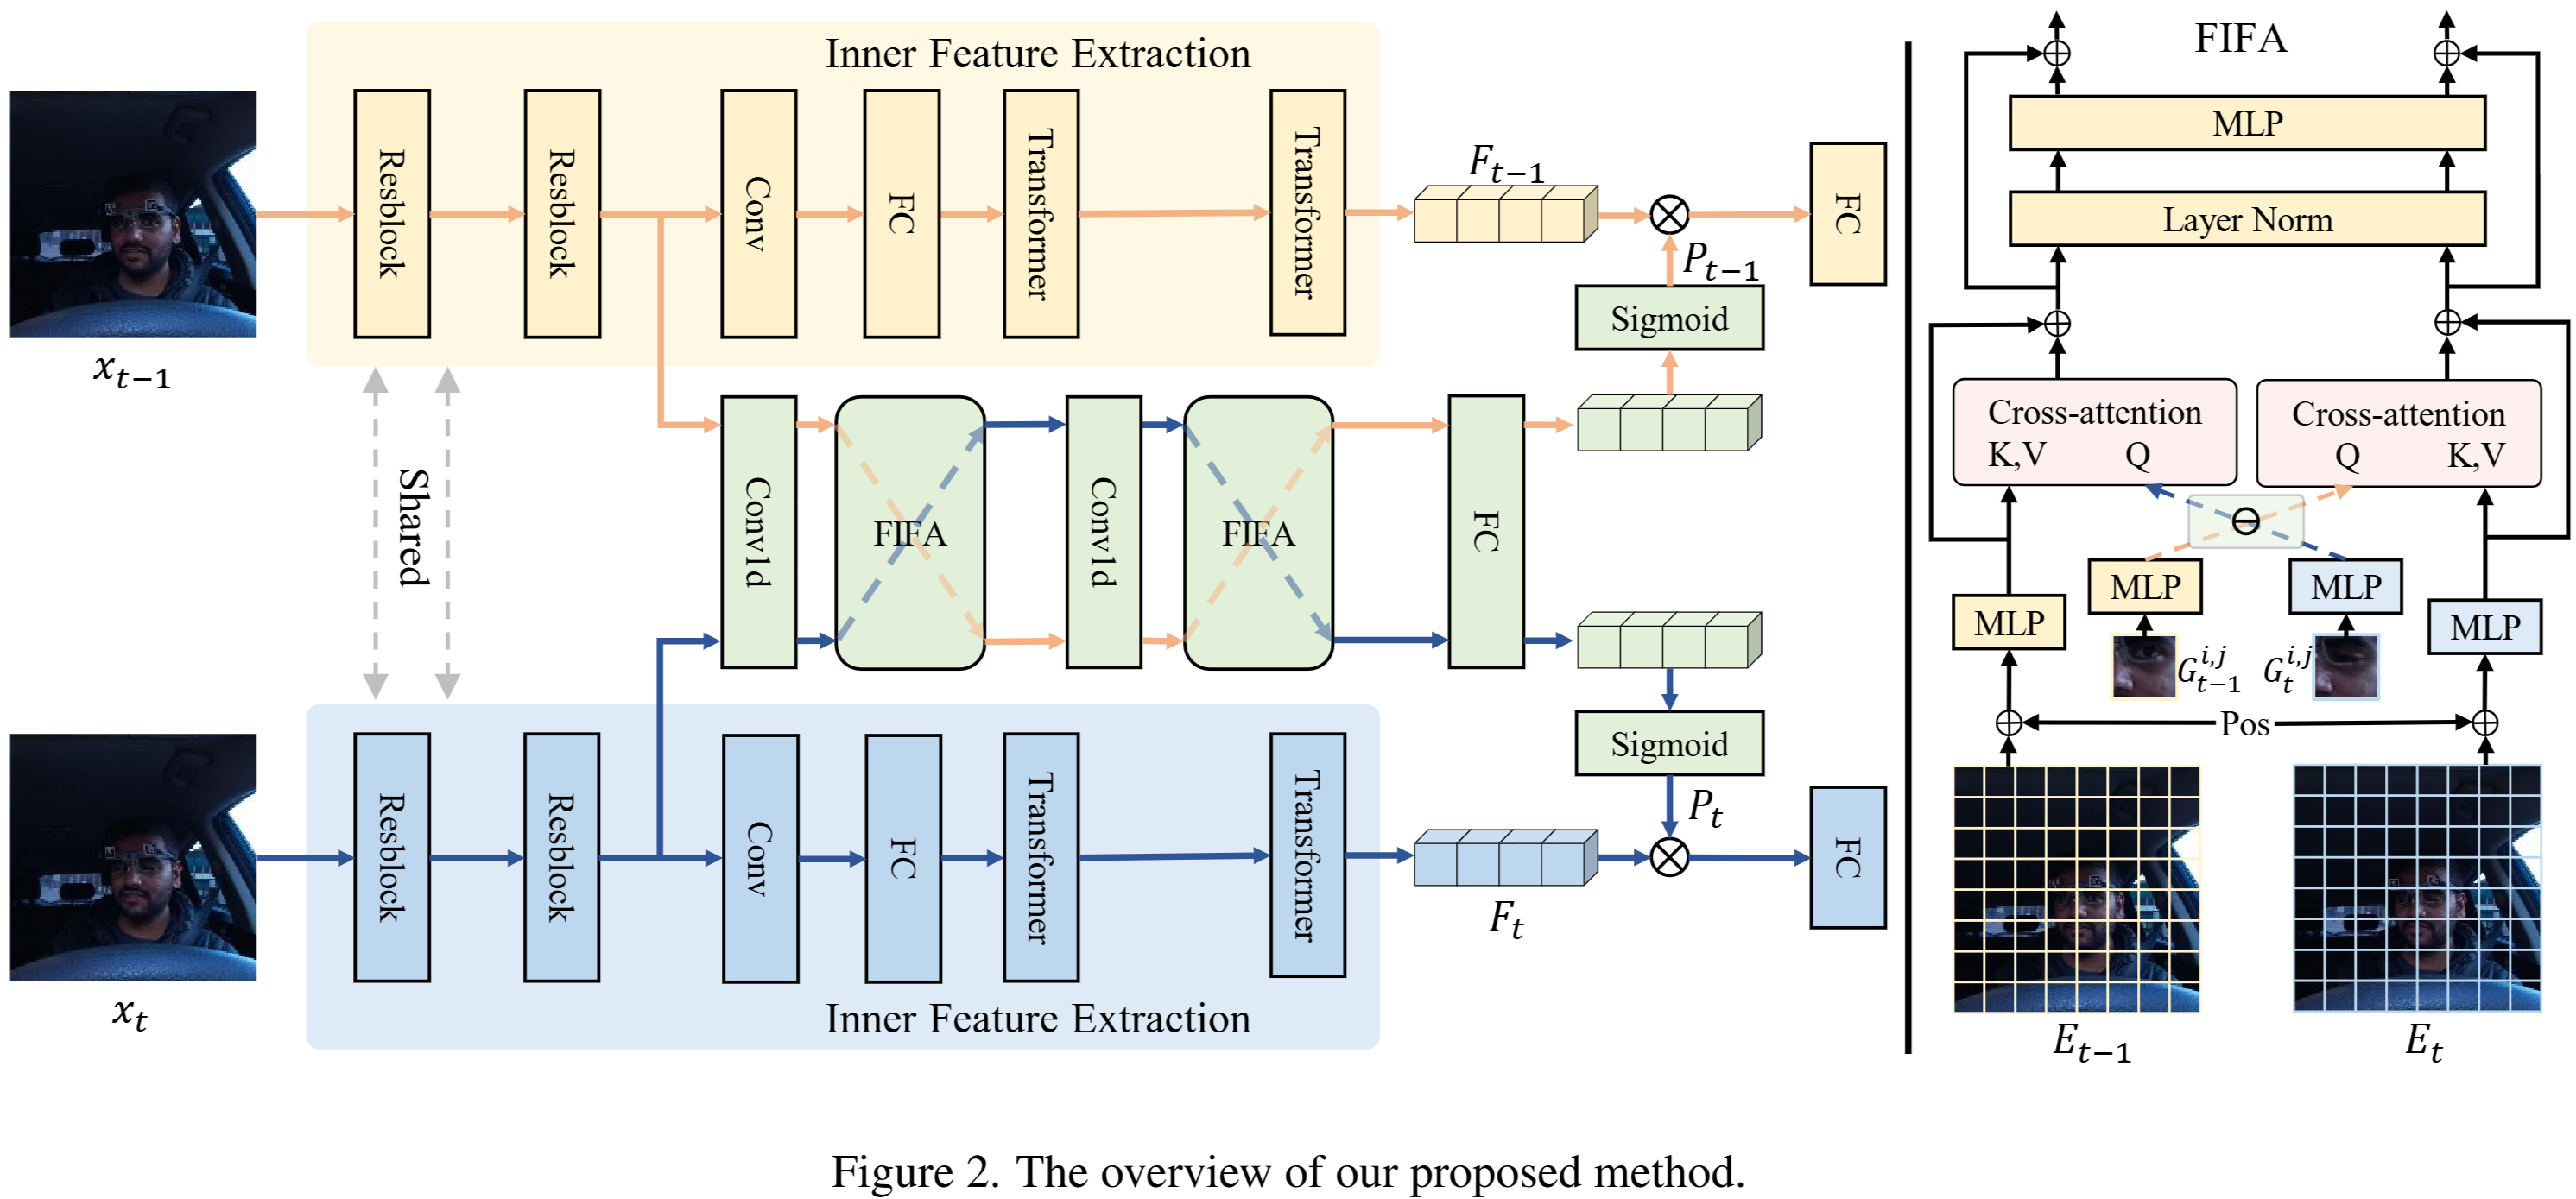
 운전자의 시선을 보다 정교하게 포착하기 위해 제안되었으며 두 프레임 사이에서 ‘무엇이 변했는지’, 즉 pupil의 미세한 위치 이동에 집중하는 논문이다. 기존 gaze estimation 방식은 크게 2가지가 있다.
- Image-based (fig.1(a))
- 한 장의 얼굴 이미지를 입력으로 사용한다. 이미지가 CNN, Transformer, MLP 등을 거쳐 시선 방향이라는 결과가 바로 나오는 ‘end-to-end’ 구조이다.
- Implicit Modeling (fig.1(b))
- 연속된 frame을 입력으로 사용한다. Cross-attention으로 frame의 특징을 비고, 섞어준다. 이 과정을 통해 프레임 사이의 공간적, 시간적 관계를 implicitly하게 학습한다.
본 논문에서는 FIFA(Fine-grained Inter-Frame Attention)라는 새로운 프레임워크를 제안하는데, 연속적인 video frame 사이의 ‘차이’를 명시적으로 학습하고, static한 head information과 dynamic한 pupil 정보를 효과적으로 분리하고 결합한다. (fig.1(c))
Contributions
- 새로운 FIFA(Fine-grained Inter-Frame Attention)
- 연속된 두 frame 간의 차이를 cross attention의 query로 활용하는 방식을 제안한다. 이를 통해 pupil의 동적인 움직임에 집중하도록 모델을 유도한다.
- 효율적인 Dual-Stream(병렬) fraemwork 제안
- Head posture(정적 정보)와 pupil(동적 정보)를 포착하는 경로를 병렬로 설계한다. 두 정보의 분리해 처리 → 결합을 통해 정보 간 간섭을 최소화했다.
- 모델 경량화
Related Work
Gaze Estimation
Image 기반과 video 기반으로 나눌 수 있다.
Image-based method
한 장의 얼굴 이미지를 사용해 시선을 추정하는 방식이다.
- 초기 연구: 별도의 장비를 사용해 눈의 특징을 포착하고, 안구의 normal vector(법선 벡터)가 시선 방향과 일치한다고 가정하여 눈 모델을 구축하는 방식이 주를 이뤘다. 이러한 방법들은 통제된 환경에서는 성능이 좋지만, 실제 환경 변화에 취약하다는 한계가 있었다.
- Deep learning based 연구: 주로 눈 이미지를 CNN에 입력하여 시선 특징을 추출하고 방향을 회귀하는 방식이 사용된다. 여기에 head posture, facial appearance 등 추가적인 정보를 함께 사용해 정확도를 높이는 것이 일반적이다.
Video-based method
Gaze의 방향의 변화를 공간적으로 연속되기 본다. 이를 통해 연속 frame에 대해 correlation을 생성한다.
- Kellnhofer et al. : Bidirectional LSTM을 사용해 연속된 프레임을 처리하며 공간 정보의 변화를 간접적으로 추론했다.
- Jindal et al. : 공간, 시간적 dynamic을 포착하기 위해 cross-attention mechanism을 제안했다.
- Guan et al. : 머리, 얼굴, 눈 사이의 시공간적 상호작용을 통해 성능을 향상시키는 multi-cue gaze estimation을 제안했다.
Gaze Estimation for Driver
- 초기 연구 : NIR 카메라나 head-mounted device를 이용해 홍채와 같은 눈의 특징을 포착하여 시선을 추론했다. 하지만 이런 장비들은 눈과의 상대적 거리가 고정되어야 하는 등 제약이 많았다.
Gaze zone estimation [16, 34]
이러한 제약 때문에 이미지 기반 연구가 활발해졌는데, 초기에는 정확한 시선 방향을 추정하는 대신 시선 영역을 추정하는 방식으로 문제를 단순화했다. 차량 내부를 여러 구역(예: 전방, 백미러, 계기판)으로 나누고, 운전자가 어느 구역을 보는지 분류하는 방식이다. 하지만 이 방식은 운전자의 정확한 시선 방향을 알 수 없다는 한계가 있었다.
Accurate gaze estimation
- Kasahara et al.에서 LBW 데이터셋을 제안하면서 운전자의 정확한 3차원 gaze estimation 연구가 본격화되었다.
- Cheng et al. : Transformer 기반 dual stream framework를 제안했다.
Method
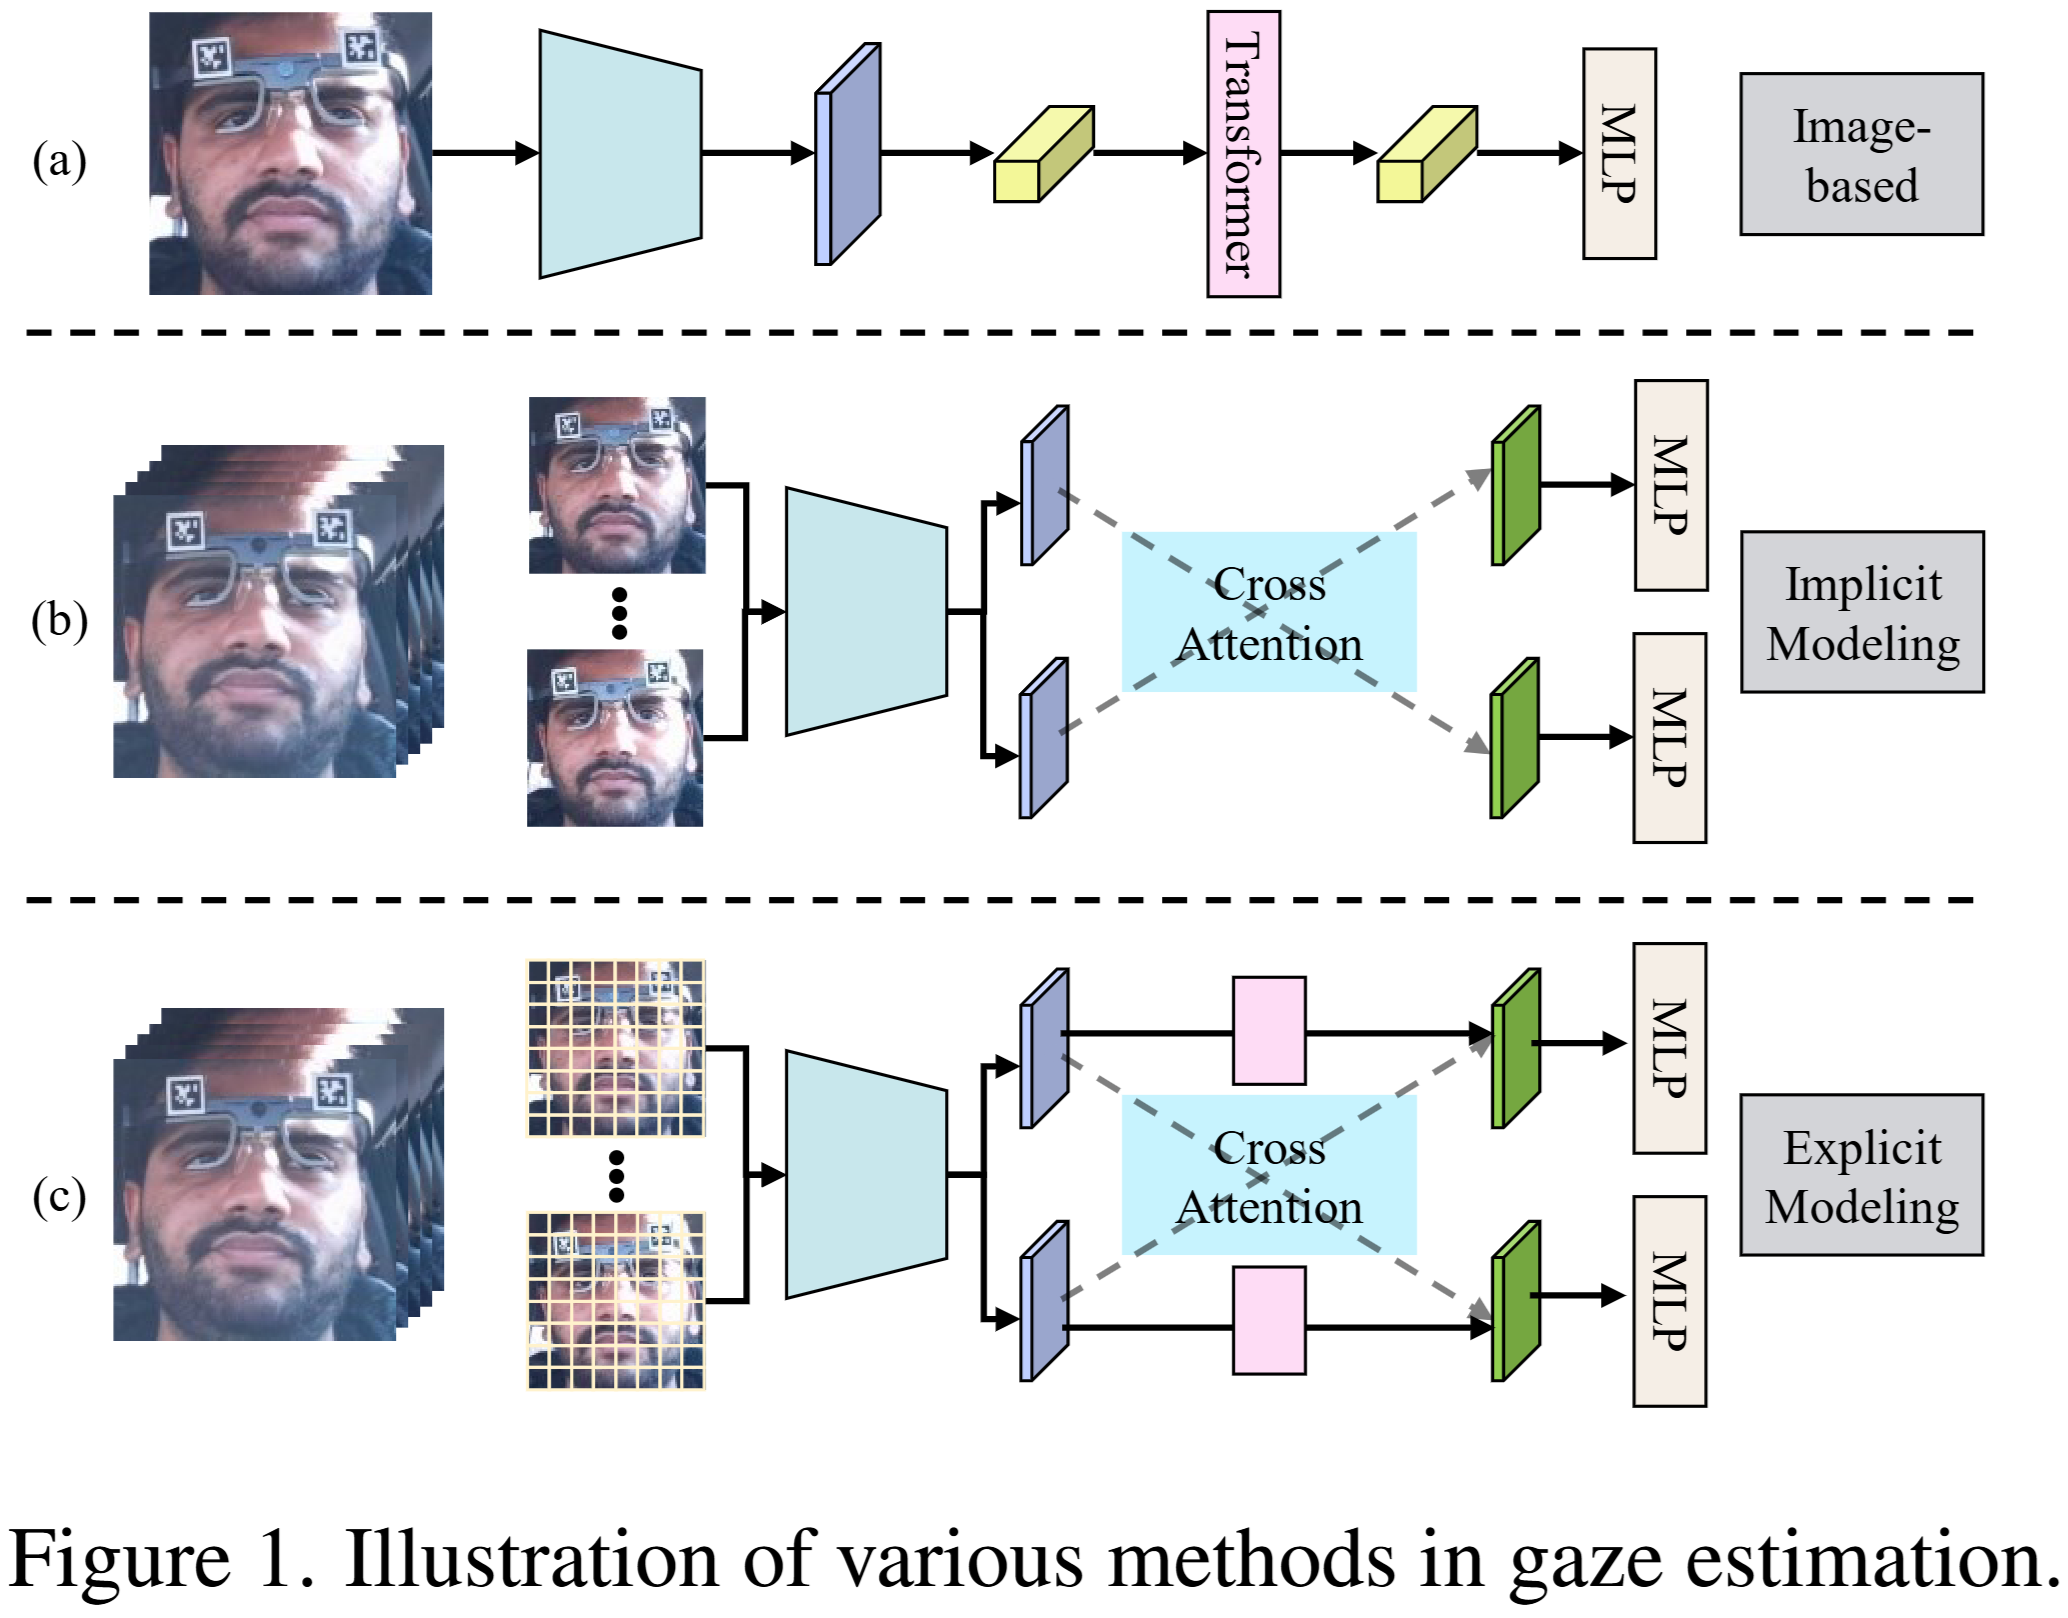
논문의 key idea는 움직임 변화이다. 이 목표를 달성하기 위해 ViT의 self-attention을 활용한다. 또한 pre-trained 모델을 활용하여 학습을 진행하였다.
Encoding of Facial Image & Inner Feature Extraction
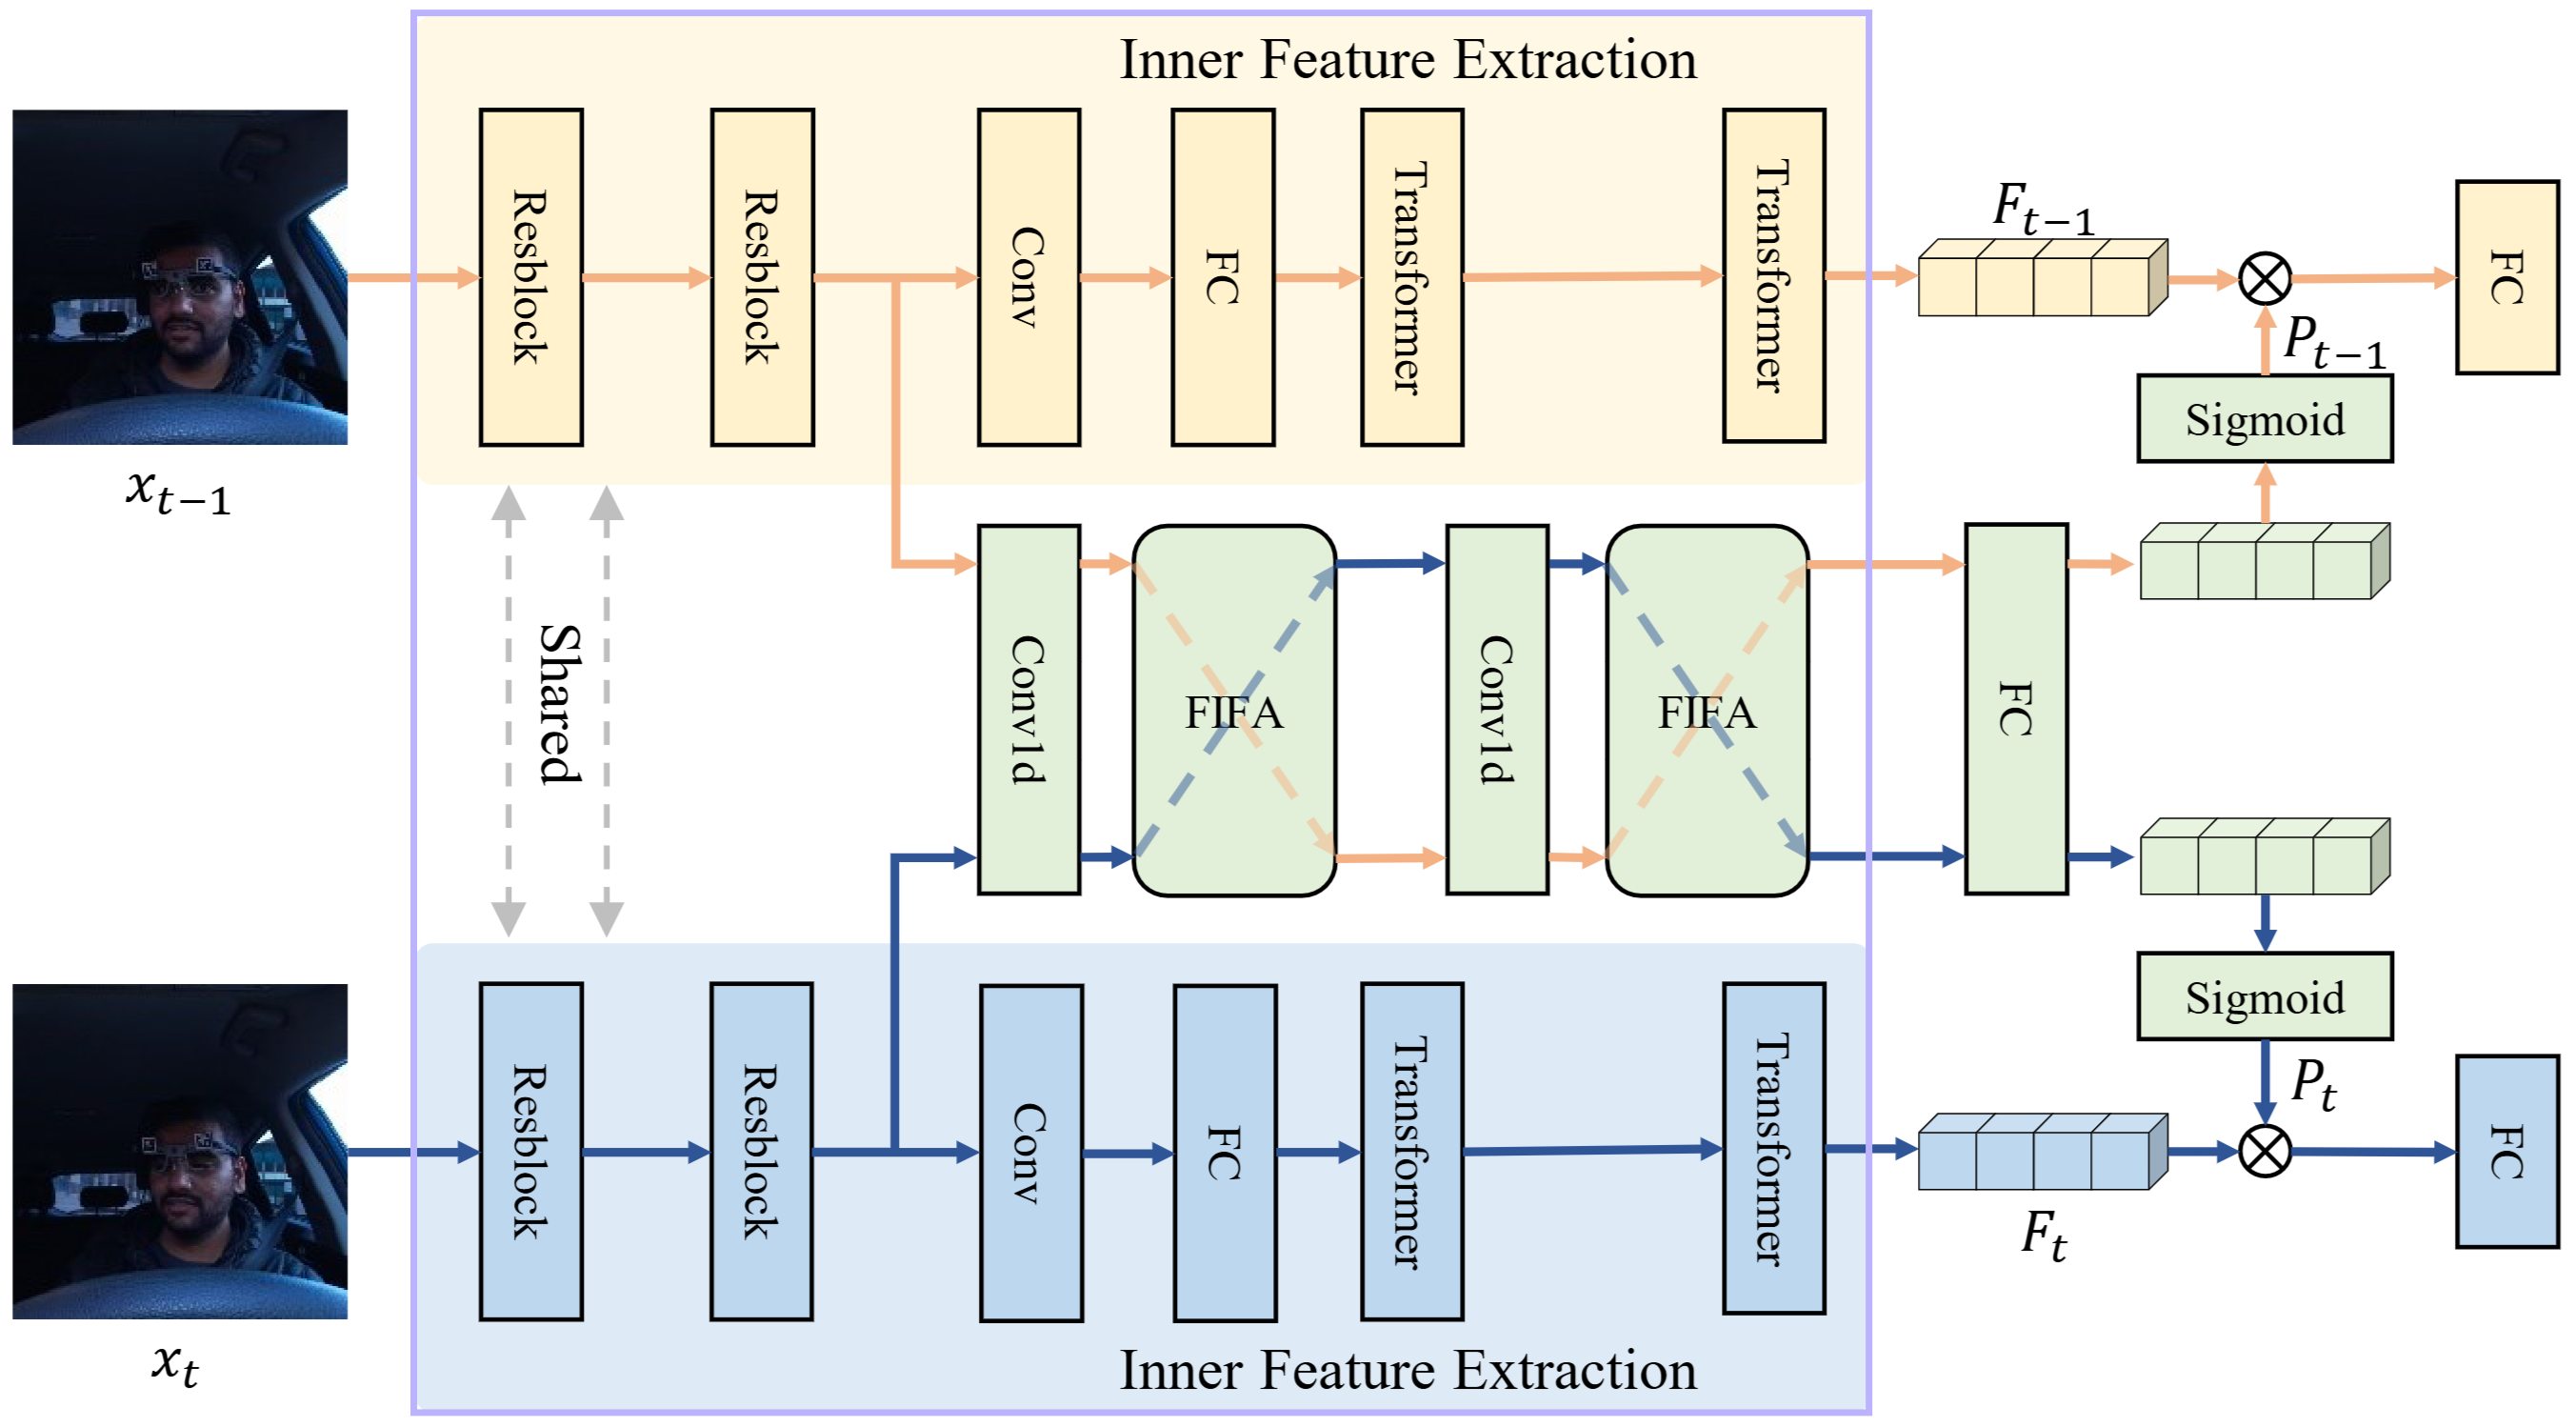
Fig.2에서는 이 둘을 하나로(Inner Feature Extraction)으로 표현했다.
얼굴 전체에서 동공이 차지하는 면적은 매우 작다. 따라서 동공의 특징을 정확하게 포착하기 위해 일반적으로 고해상도의 이미지를 입력으로 받는다. 그러나 처리해야할 patch의 개수가 많아져 계산비용이 커진다. 따라서 ResNet18의 초기 레이어 2개를 이용해 원본 이미지($3\times 224\times 224$)를 feature map($128\times 28\times 28$)으로 변환한다. 해상도는 낮아지지만, 정보는 보존하도록 한다.
\[E_{t-1}, E_t = \mathcal{R}(x_{t-1}, x_t)\]Encoding을 통해 얻은 low-level feature에는 gaze feature와 appearance detail 정보가 풍부하게 존재한다.
이후 Transformer를 사용해 feature map $E$를 여러 개의 작은 patch로($E^{i,j}$) 나눈다. 각 patch를 convolution에 통과시킨 뒤 flatten하여 feature vector로 만들고, linear projection을 통해 고차원의 feature space로 보낸다. 각 patch의 위치 정보를 나타내는 positional encoding을 추가한다. 이후 transformer의 self-attention 메커니즘에 통과한다.
\[F = \sum T(L(\text{Conv}(E^{i,j})) + Pos)\]Fine-grained Inter-frame Attention (FIFA)
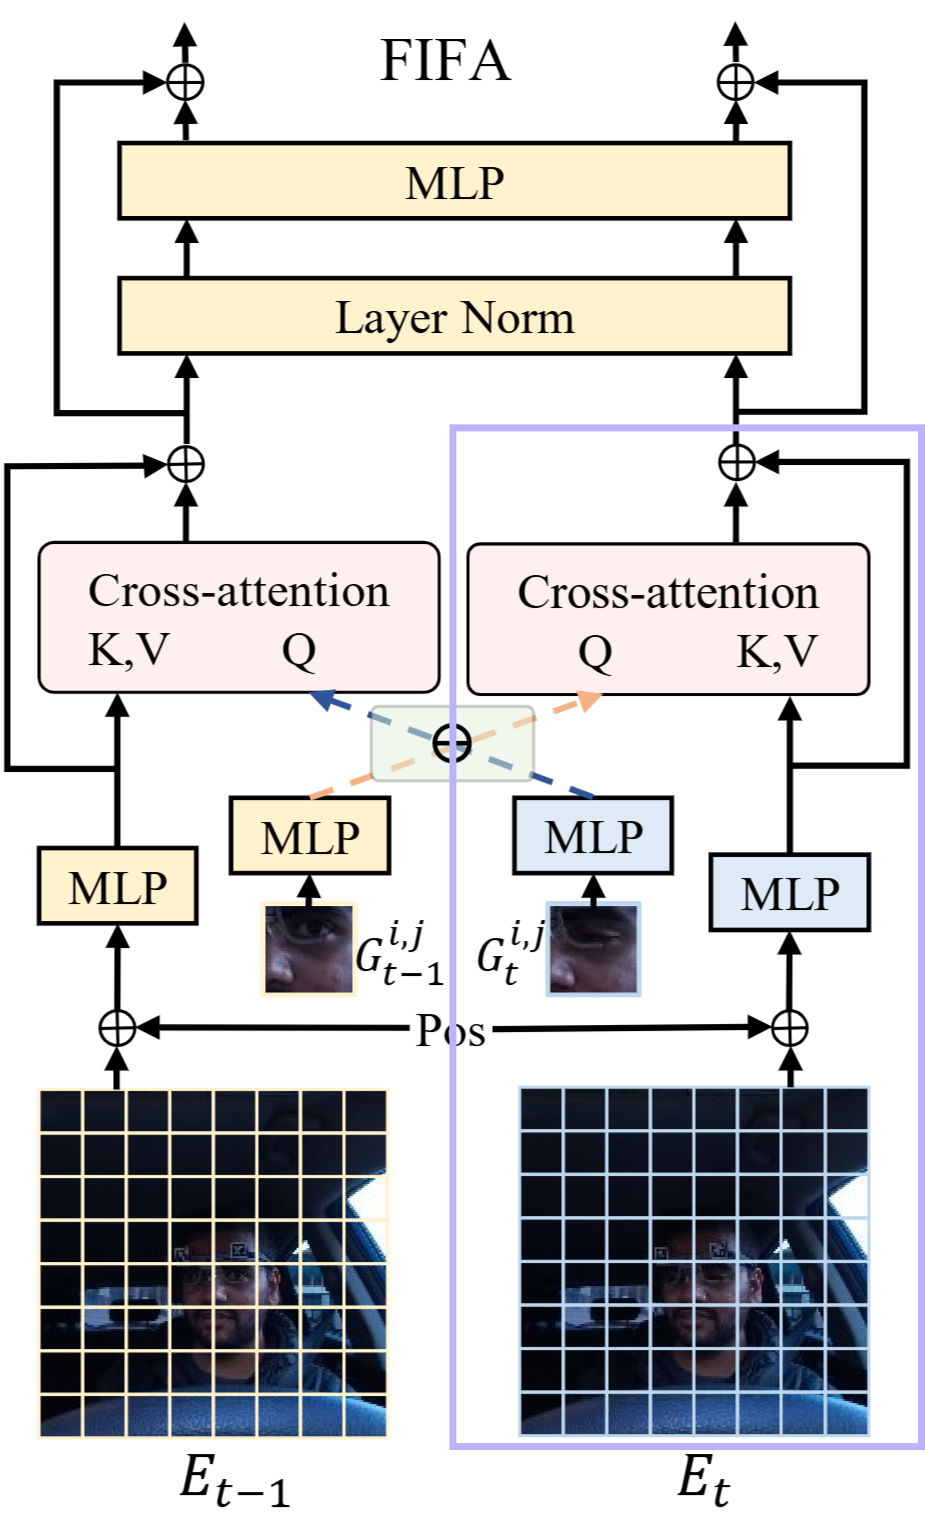 FIFA의 근본적인 아이디어는 짧은 시간 동안의 gaze 변화는 동공의 위치 이동으로 나타난다는 것이다. FIFA의 입력은 Encoding 후의 feature인 $E_{t-1}$와 $E_t$이다. 이 feature map으로 patch $G^{i,j}$를 만든다. FIFA에서 사용하는 cross-attention에서는 Query를 두 patch 사이의 변화량으로 정의한다.
이후 attention을 계산한다.
\[S_{t-1 \to t}^{i,j} = \text{SoftMax}\left(\frac{Q_{t-1}^{i,j} \cdot (K_t^{n,i,j})^T}{\sqrt{d_k}}\right)\]Attention map을 value $V_t^{n,i,j}$와 곱한 뒤, 원래 patch($G_{t−1}^{i,j}$)에 더해준다.
\[\hat{x}_{t}^{i,j} = \hat{G}_{t}^{i,j}, \quad i,j \in [0, n]\] \[\hat{G}_{t-1}^{i,j} = G_{t-1}^{i,j} + S_{t-1 \to t}^{i,j} \cdot V_{t}^{n,i,j}\] \[\hat{x}_{t-1}^{i,j} = \hat{G}_{t-1}^{i,j}, \quad i,j \in [0, n]\]이렇게 강화된 패치들을 다시 원래 위치대로 합치면, 동공의 움직임 같은 중요한 변화가 강조된 feature map($\hat{x}_{t-1}, \hat{x}_t$)이 만들어진다.
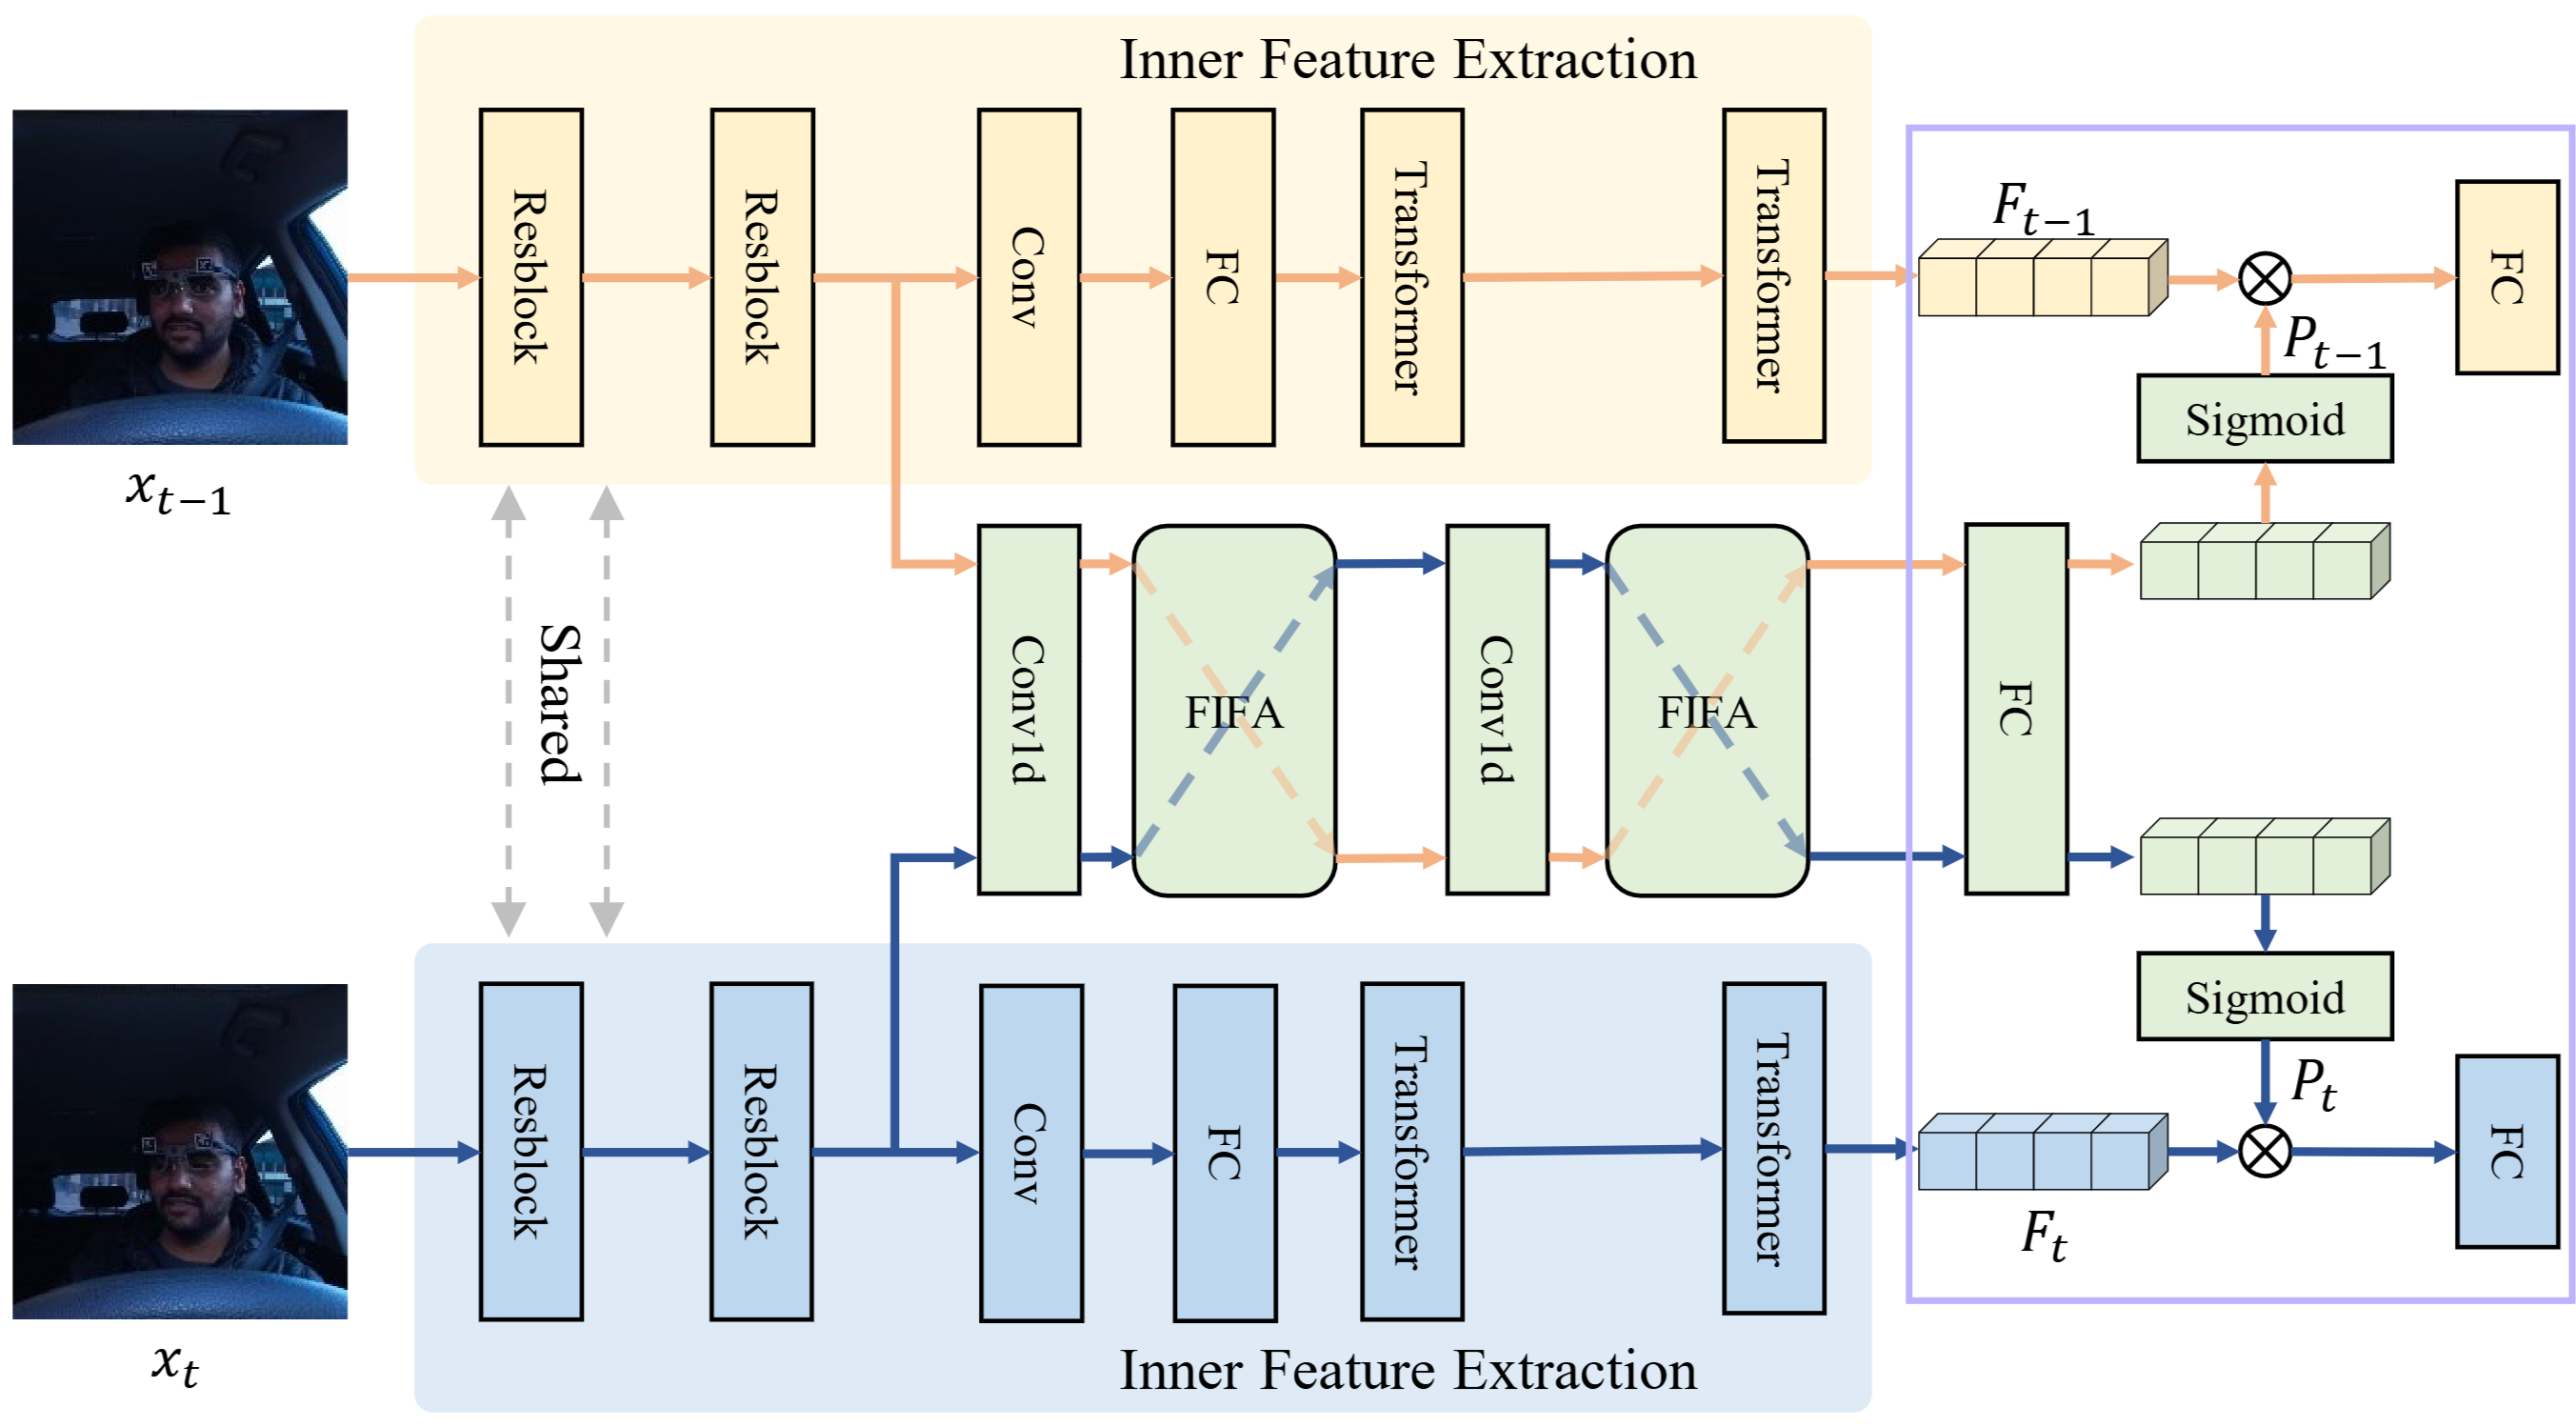
FIFA 모듈을 통해 얻은 motion 정보는 inner feature extraction에서 얻은 정보와 합쳐진다.
\[P_{t-1}, P_t = \text{Sig}(\text{FC}(\text{Flatten}(\hat{x}_{t-1}, \hat{x}_t)))\] \[\hat{F}_{t-1} = P_{t-1} \odot F_{t-1}\] \[\hat{F}_{t} = P_{t} \odot F_{t}\]최종적으로 $t-1$과 $t$에 대한 예측값 $\hat{g}_{t-1}, \hat{g}_t$이 나오게 된다.
Loss는 다음과 같이 구한다.
\[\mathcal{L} = 0.5\|\hat{g}_t - g_t\| + 0.5\|\hat{g}_{t-1} - g_{t-1}\|\]Experiments
Dataset
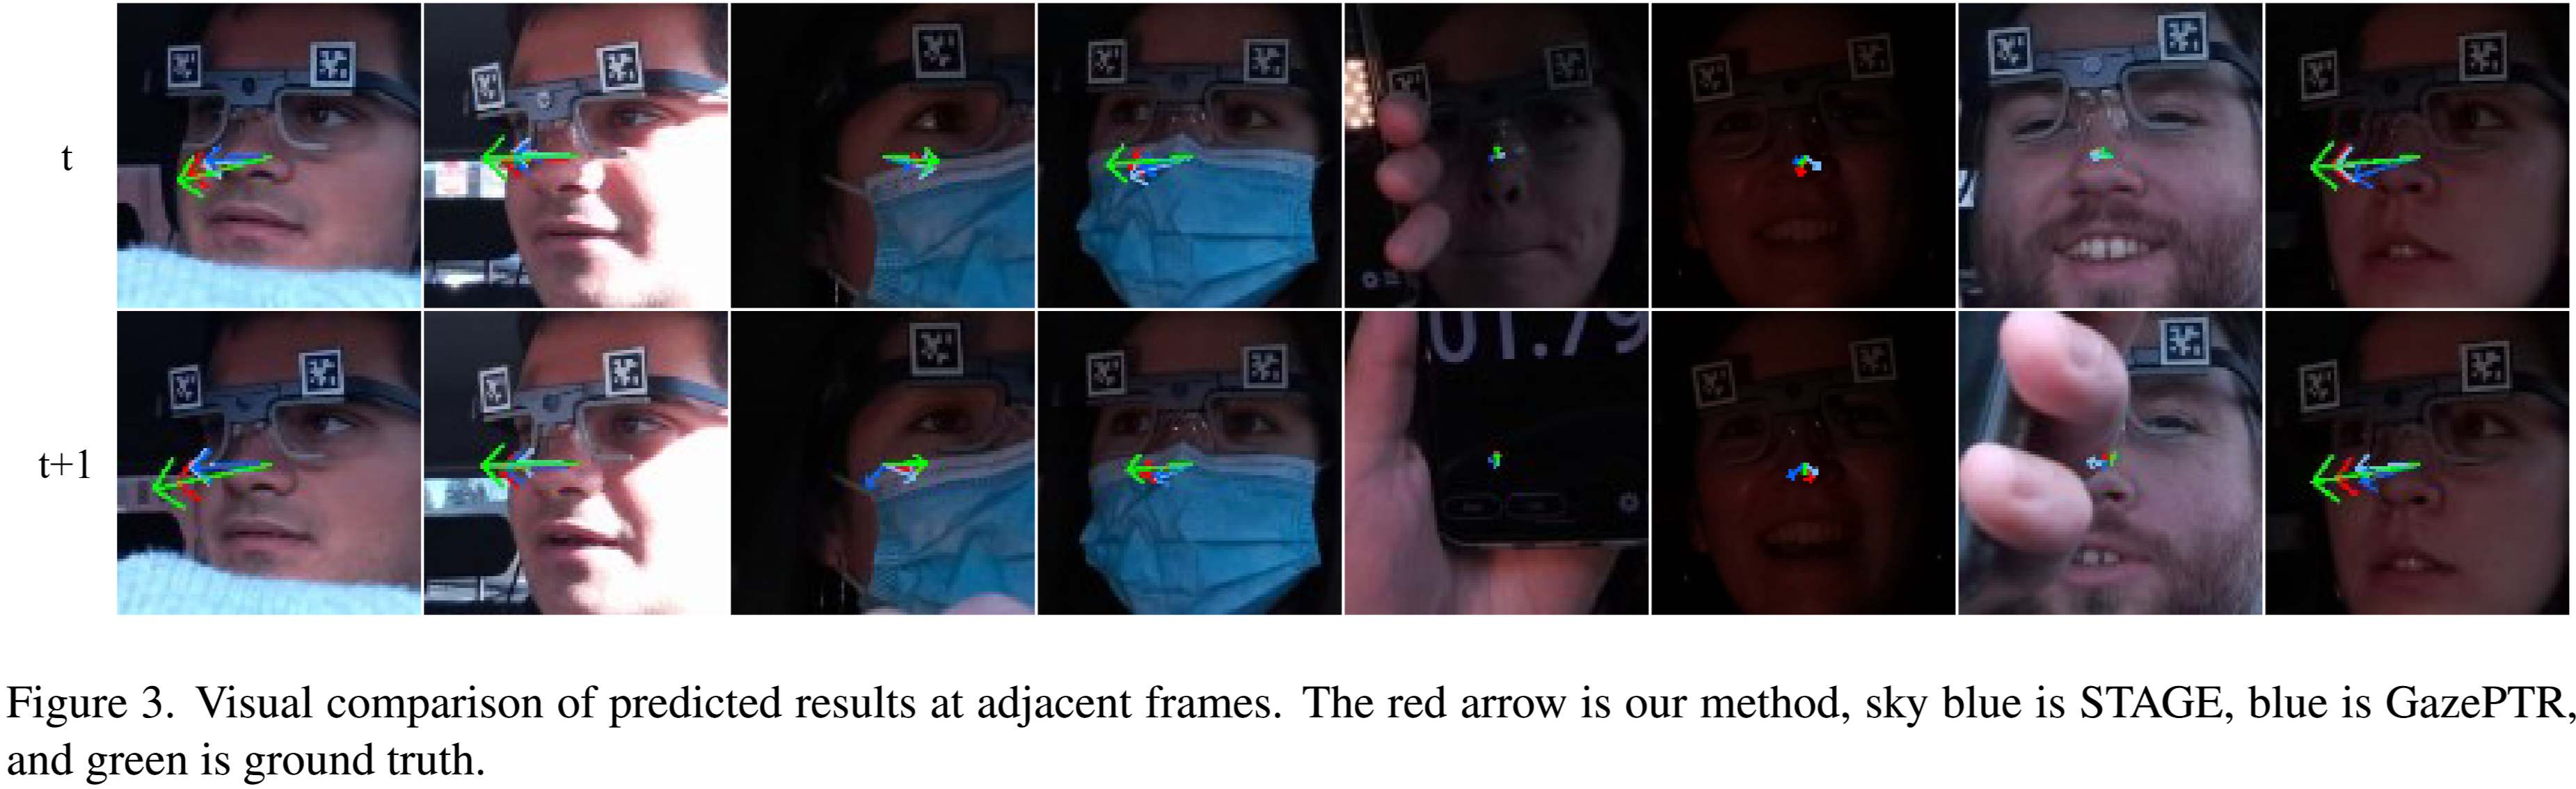
LBW(Look Both Ways)
LBW는 운전자의 얼굴 이미지, 도로를 향하는 장면 이미지, 그리고 머리에 장착된 아이 트래커로부터 수집된 3D 시선 방향 데이터를 포함하는 대규모 데이터셋이다.
- 구성 : 총 28명의 피실험자
- 이미지 처리 : face landmark를 사용하여 운전자의 얼굴 이미지를 $224\times224$ 크기로 잘라서 사용
- 분할 방식 : 이 연구에서는 피실험자의 ID를 기준으로 22번까지는 train, 그 이후는 test로 나누어 사용
- 프레임 구성 : train 시에는 데이터셋에 있는 인접한 이미지들을 연속된 프레임으로 간주하여 사용
IV(In-Vehicle)
- 구성 : 125명의 피실험자로부터 수집된 총 44,705개의 이미지
- 특징: 머리 자세(head pose)와 시선 방향을 포함한 풍부한 정답(ground truth) 데이터를 제공
- 평가 방식: 이전 연구에서 제시된 분할 전략에 따라 피실험자를 기준으로 3개의 subset으로 나누어 three-fold cross-validation을 수행
- 프레임 구성: 동일한 subset 내에서 head pose가 유사한 이미지들을 찾아 인접 프레임으로 사용. 유사한 이미지가 없을 경우, 원본 이미지를 복제하여 인접 프레임 역할을 하도록 함
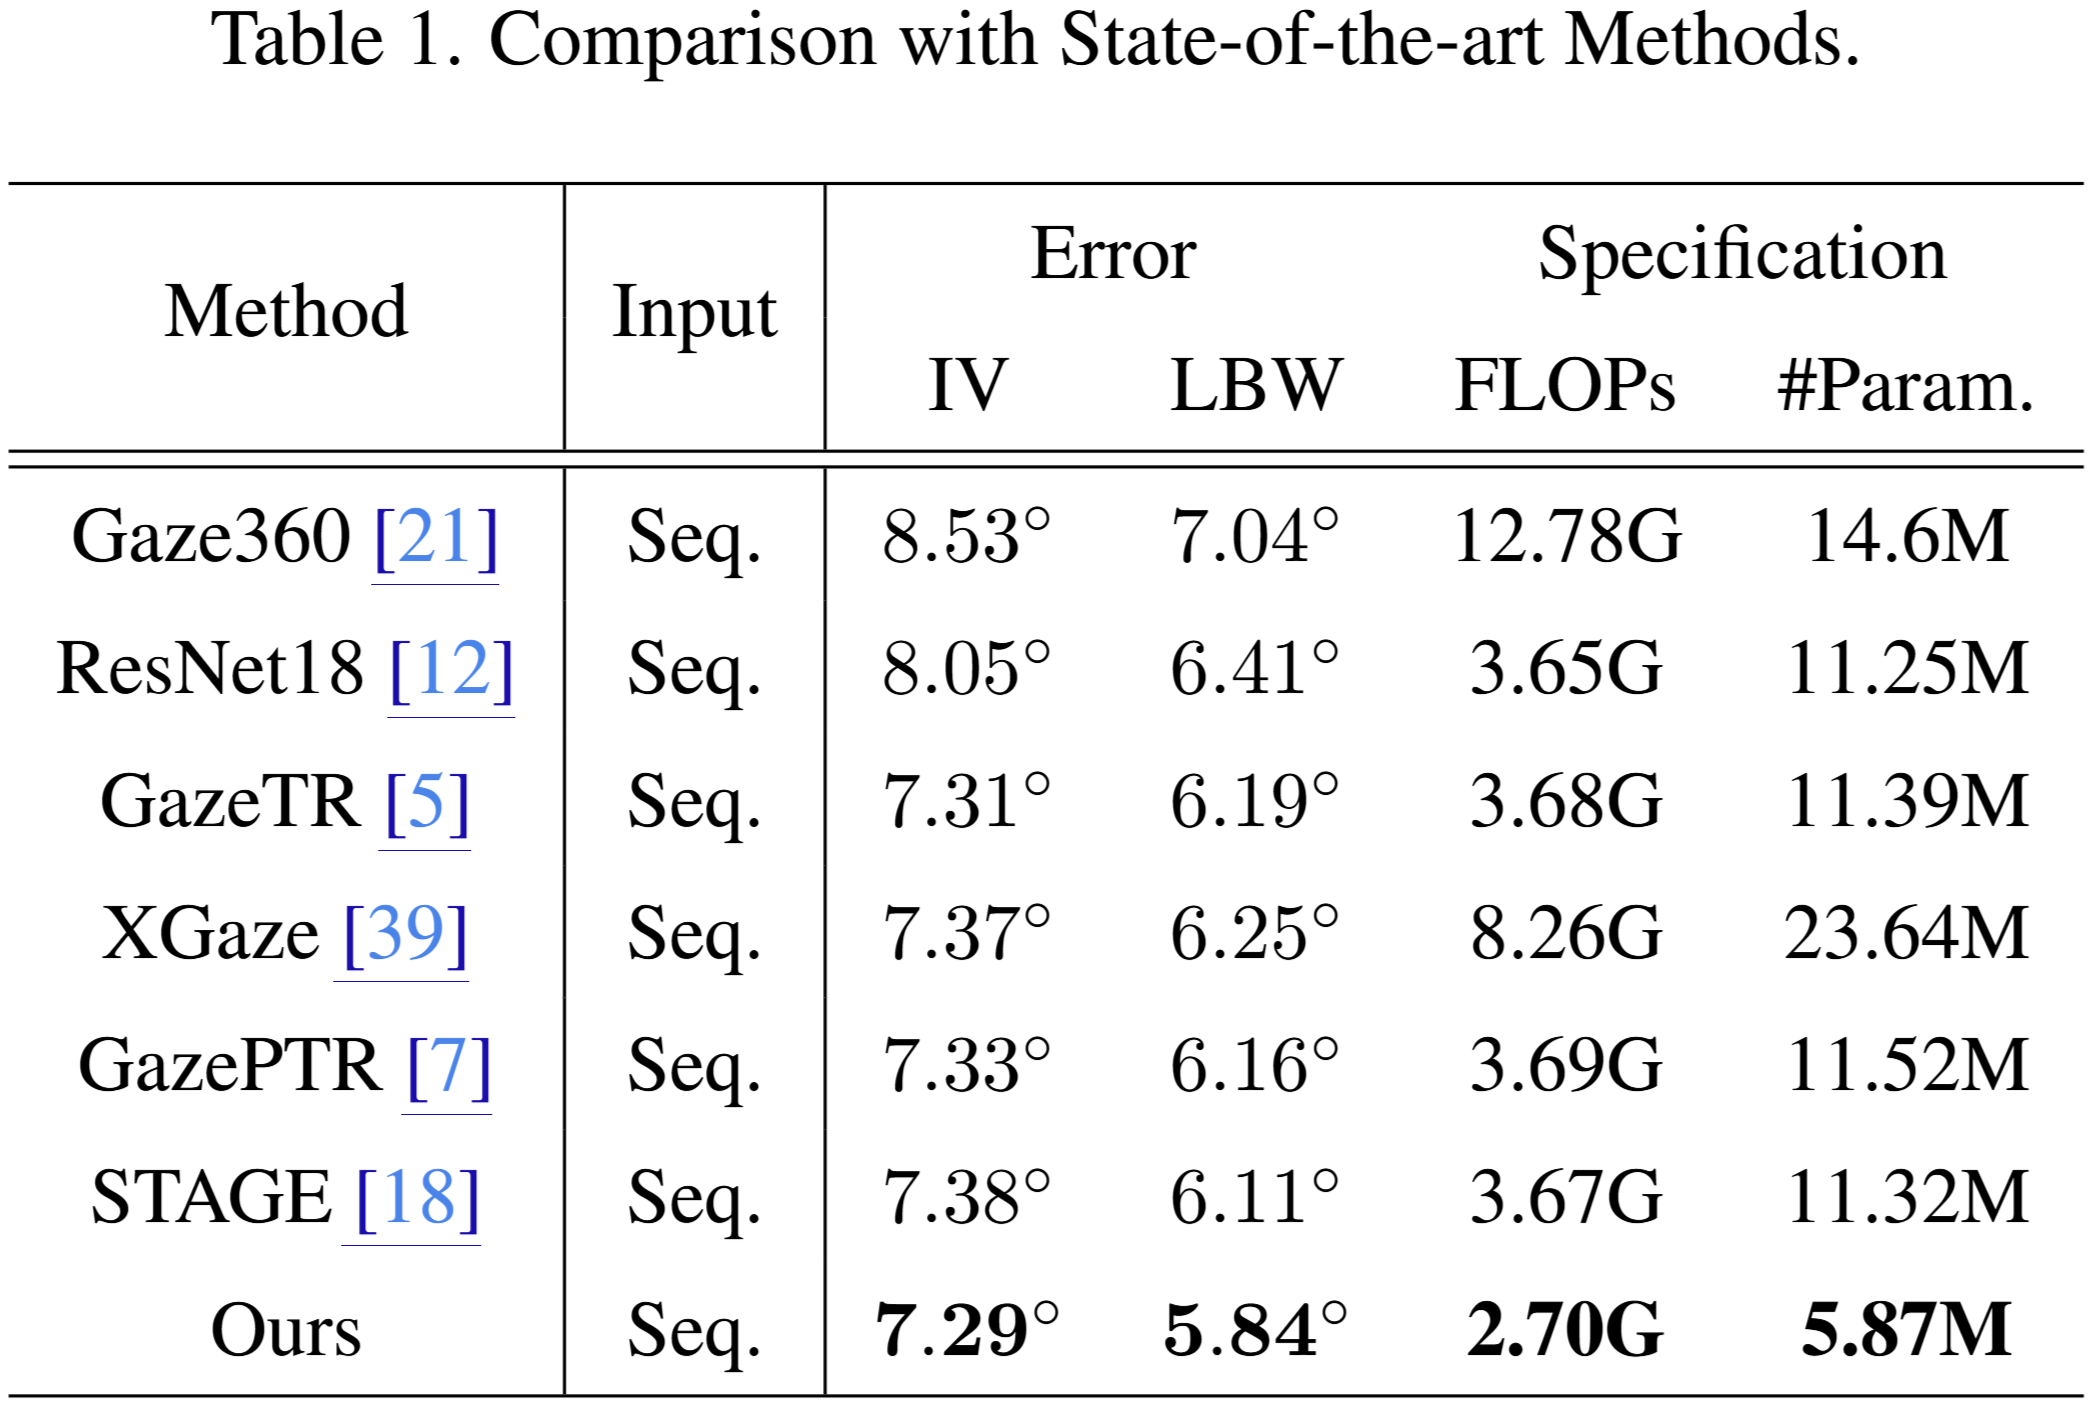
Metric - Mean of Angle Error (평균 각도 오차)
- Gaze direction = 3D vector
먼저, 사람의 시선 방향은 눈에서부터 바라보는 지점을 향하는 3차원 공간상의 화살표(3D 벡터)로 표현된다. 모델의 목표는 이 화살표의 방향을 최대한 정확하게 예측하는 것이다.
- 각도 오차 (Angle Error) 계산
하나의 test iamge에 대해, 모델이 예측한 ‘예측 화살표’와 실제 ‘정답 화살표’가 존재한다. ‘angle error’는 이 두 화살표가 서로 얼마나 빗나가 있는지를 각도(degree, °)로 측정한 값이다.
- 예측이 완벽할 경우: 두 화살표가 정확히 겹치므로 각도 오차는 0°이 된다.
예측이 빗나갈 경우: 두 화살표가 벌어진 만큼 5°, 10° 등으로 오차 값이 커진다.
- 평균 (Mean) 계산
Mean of angle Error는 test에 있는 모든 이미지에 대해 이 ‘angle error’를 각각 계산한 뒤, 그 값들을 전부 더해 전체 이미지 수로 나눈 평균값이다. 예를 들어, 1,000개의 이미지로 모델을 테스트했을 때 각각의 각도 오차를 모두 더한 총합이 6,000°였다면, 이 모델의 평균 각도 오차는 6°가 된다.
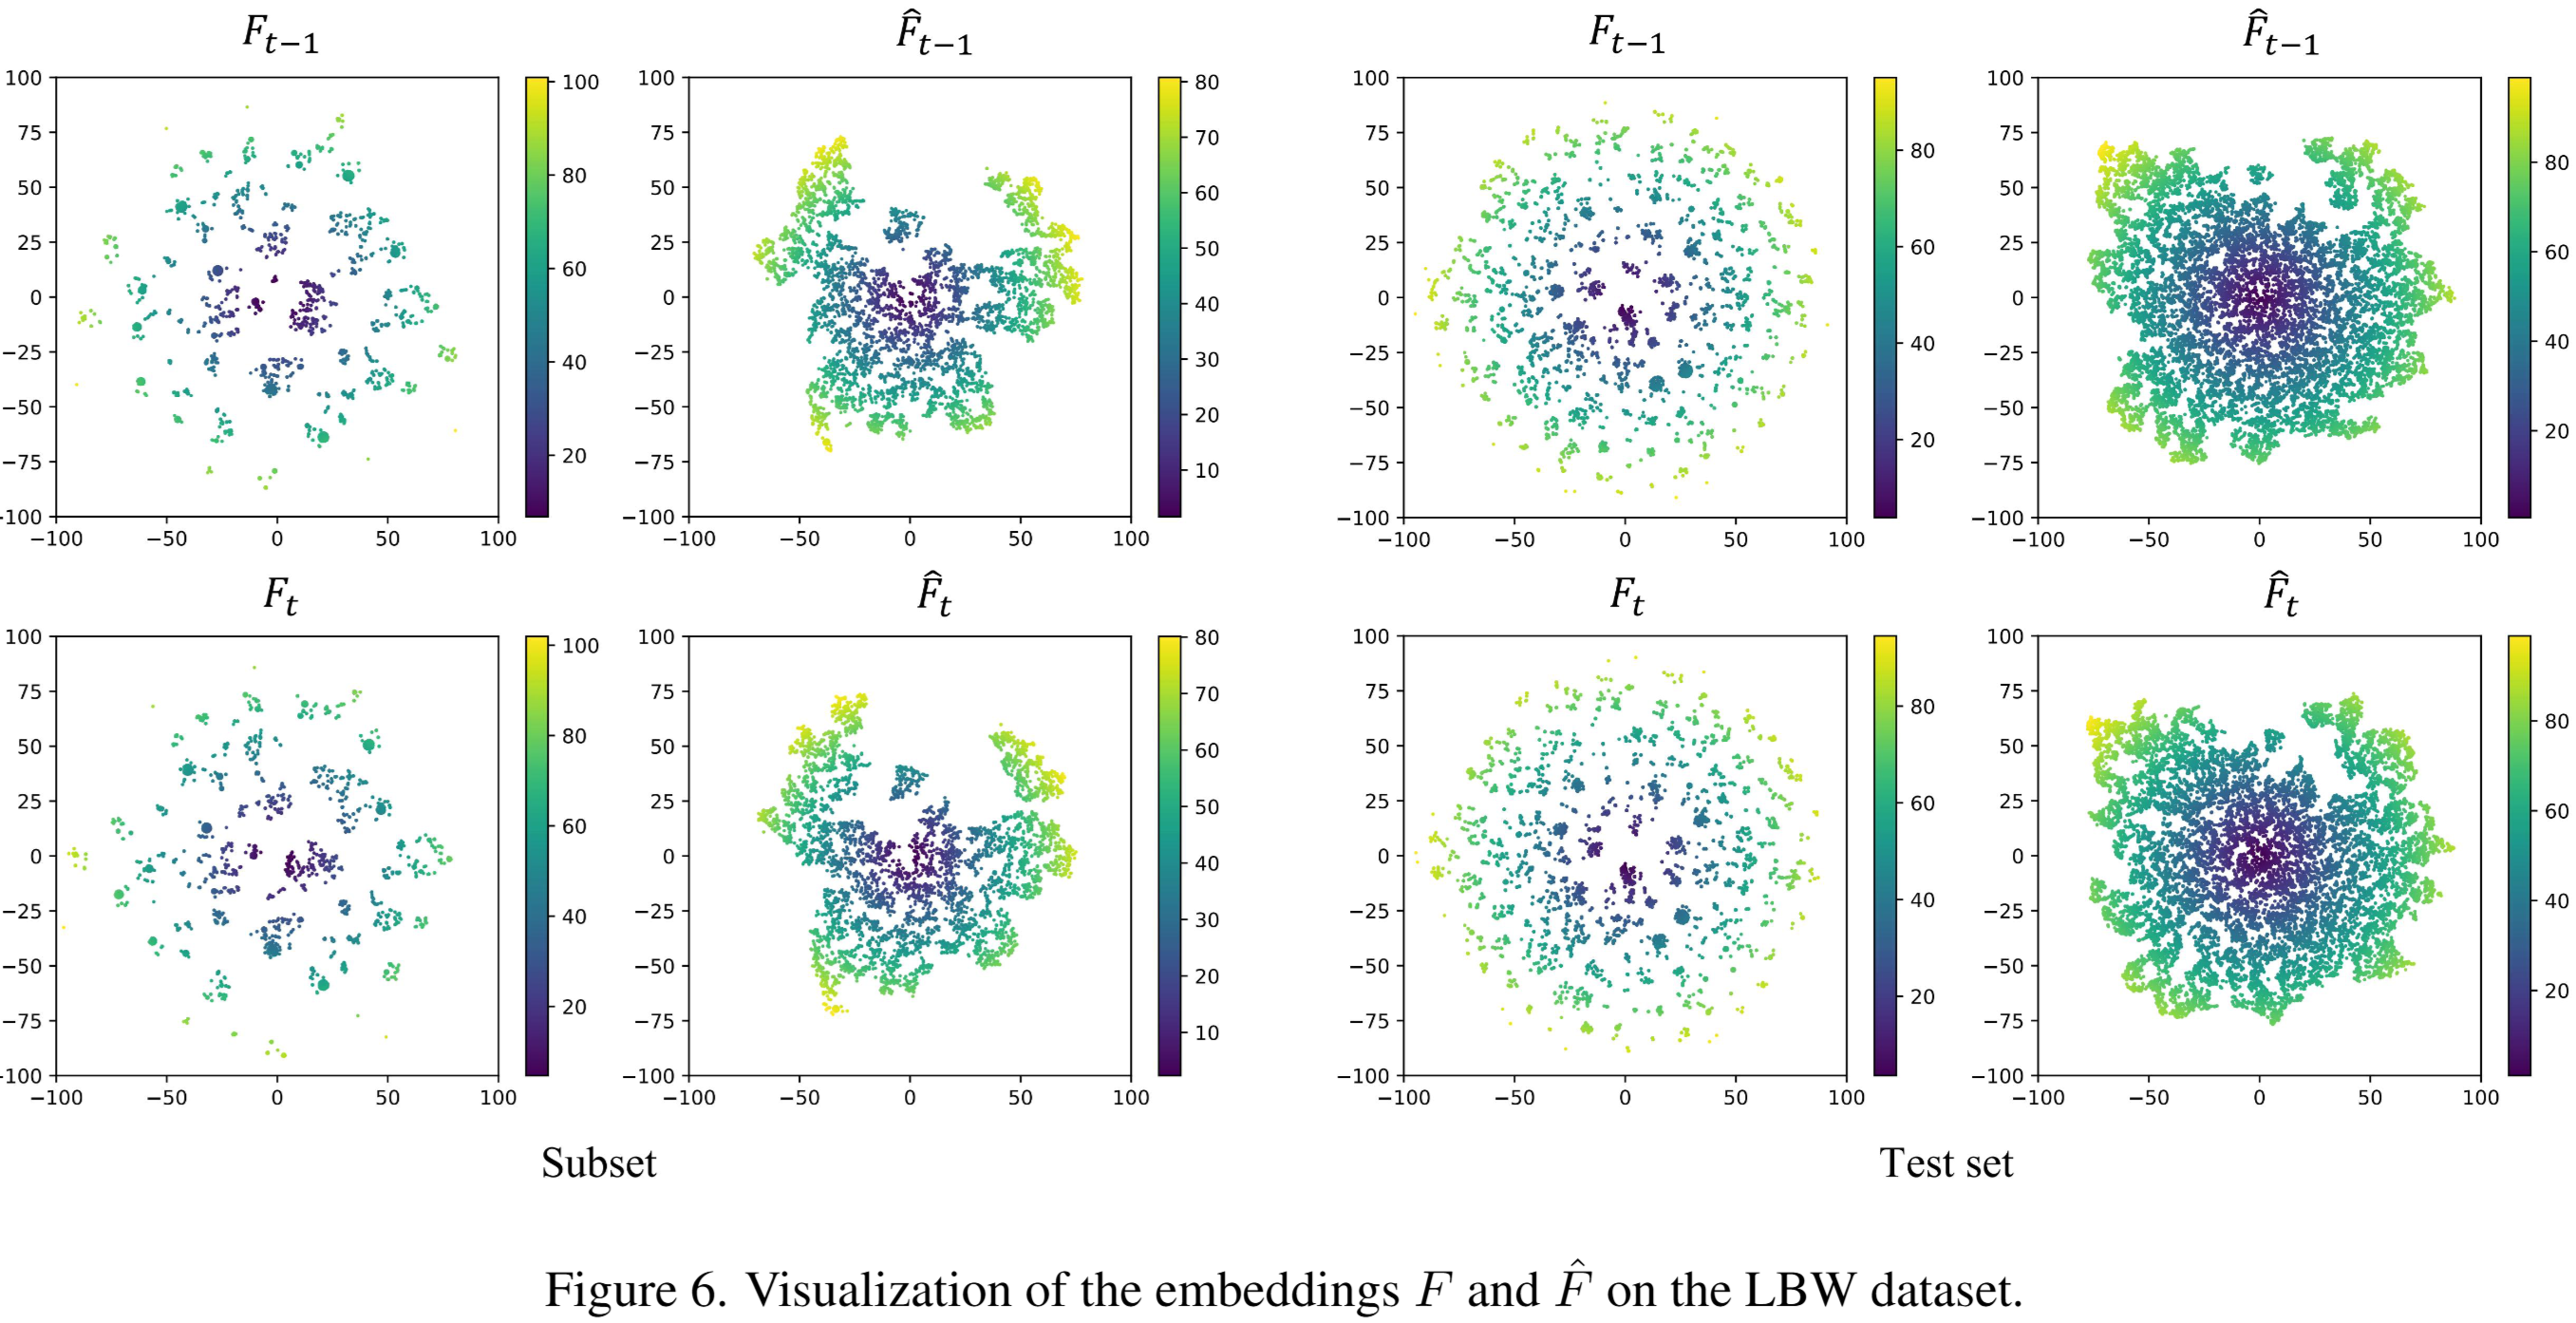
Fig. 6은 제안된 FIFA 모듈이 모델이 학습하는 feature representation의 품질을 어떻게 향상시키는지를 시각적으로 증명한다. Fig. 6는 t-SNE 알고리즘을 사용해 고차원의 시선 임베딩을 2차원으로 시각화했다. t-SNE는 고차원 공간에서 가까운 데이터 포인트들이 2차원 공간에서도 가깝게 유지되도록 하여 데이터의 구조를 시각화하는 기법이다.
- $F$ vs. $\hat{F}$
- $F$ : FIFA의 weight가 적용되기 전의 gaze embedding이다. Inner Feature Extraction 경로에서 생성된다.
- $\hat{F}$ : FIFA의 weight가 적용된 최종 gaze embedding이다.
- Subset vs. Test set
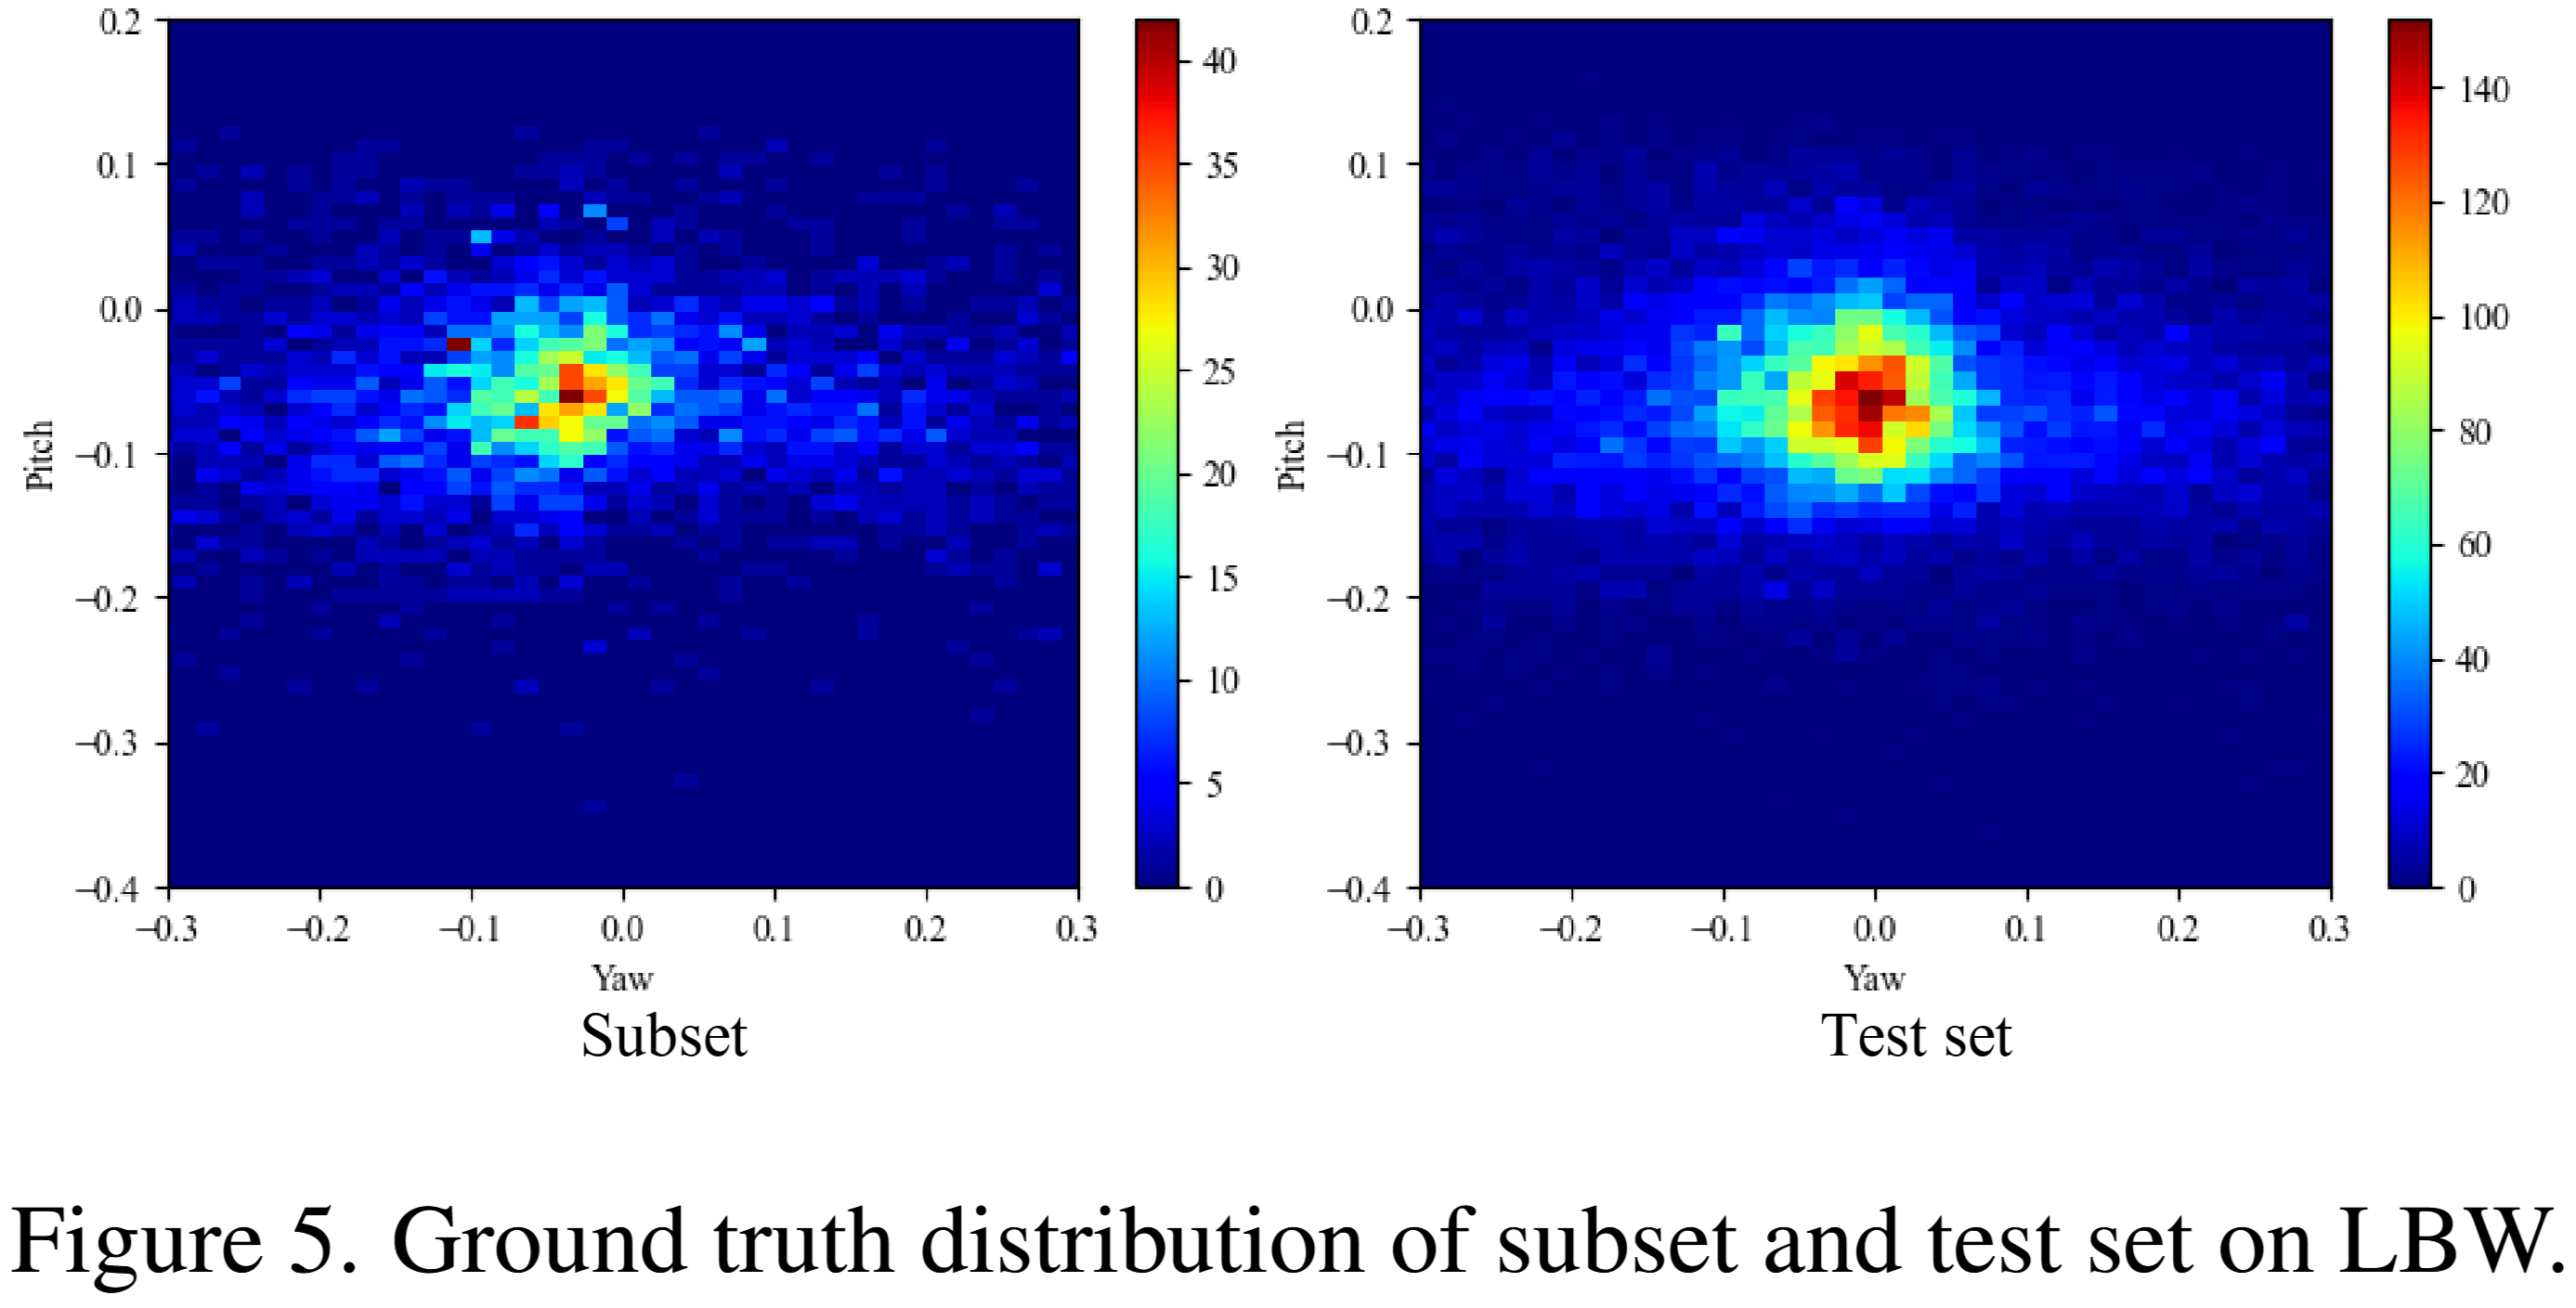
- Subset: 주로 정면을 응시하는 데이터가 밀집된, 편향된 분포를 가진 데이터 그룹이다.
- Test set: 시선 방향이 전체적으로 더 균일하게 분포된 데이터 그룹이다.
$F$의 분포는 전체적으로 듬성듬성하며 특정 영역에 뭉치는 패턴을 보인다. 논문에서는 이러한 현상이 모델이 gaze 정보 외에 운전자 개인별 특성(personalization)과 같은 부가 정보에 의해 영향을 받았기 때문이라고 분석한다. 이는 embedding의 품질을 저하시키는 요인으로 작용할 수 있다. 또한, $F$의 분포는 subset과 test set의 실제 데이터 분포(편향/균일)를 제대로 반영하지 못한다.
$\hat{F}$의 분포는 F에 비해 훨씬 refine된 형태를 보인다. 특히 test set에서는 전체 임베딩 공간에 걸쳐 더 균일한 분포를 나타낸다. $\hat{F}$의 분포는 실제 데이터의 통계적 분포와 매우 유사하게 정렬된다. 즉, 편향된 분포를 가진 subset에 대해서는 embedding 또한 밀집된 형태로, 균일한 분포를 가진 test set에 대해서는 균일한 형태로 나타난다. 이는 FIFA 모듈이 불필요한 특성의 영향을 줄이고, 모델이 데이터의 실제 구조를 더 잘 학습하도록 돕는다는 것을 의미한다.